Si le haces la misma pregunta a ChatGPT hoy y mañana, a menudo obtendrás dos respuestas distintas. Unas veces aparece tu marca y otras no. ¿Se puede medir entonces la visibilidad en IA?
- Las respuestas individuales de la IA son realmente aleatorias
- La pregunta clave: ¿repetir o ampliar?
- Por qué gana la amplitud
- Muchos prompts compensan la fluctuación
- Cuándo siguen teniendo sentido las consultas diarias
- Preciso no es lo mismo que exacto
- En el conjunto propio: estable para tu marca, incierto para la competencia
- Qué significa esto
Se puede medir de forma fiable, solo que de otra manera de lo que sugieren muchas herramientas y guías. Hemos analizado 10.826 series de medición diarias a partir de datos de SISTRIX, en cuatro modelos de IA y ocho países. El resultado es claro: si quieres cifras fiables, no deberías consultar el mismo prompt una y otra vez, sino el mayor número posible de prompts distintos.
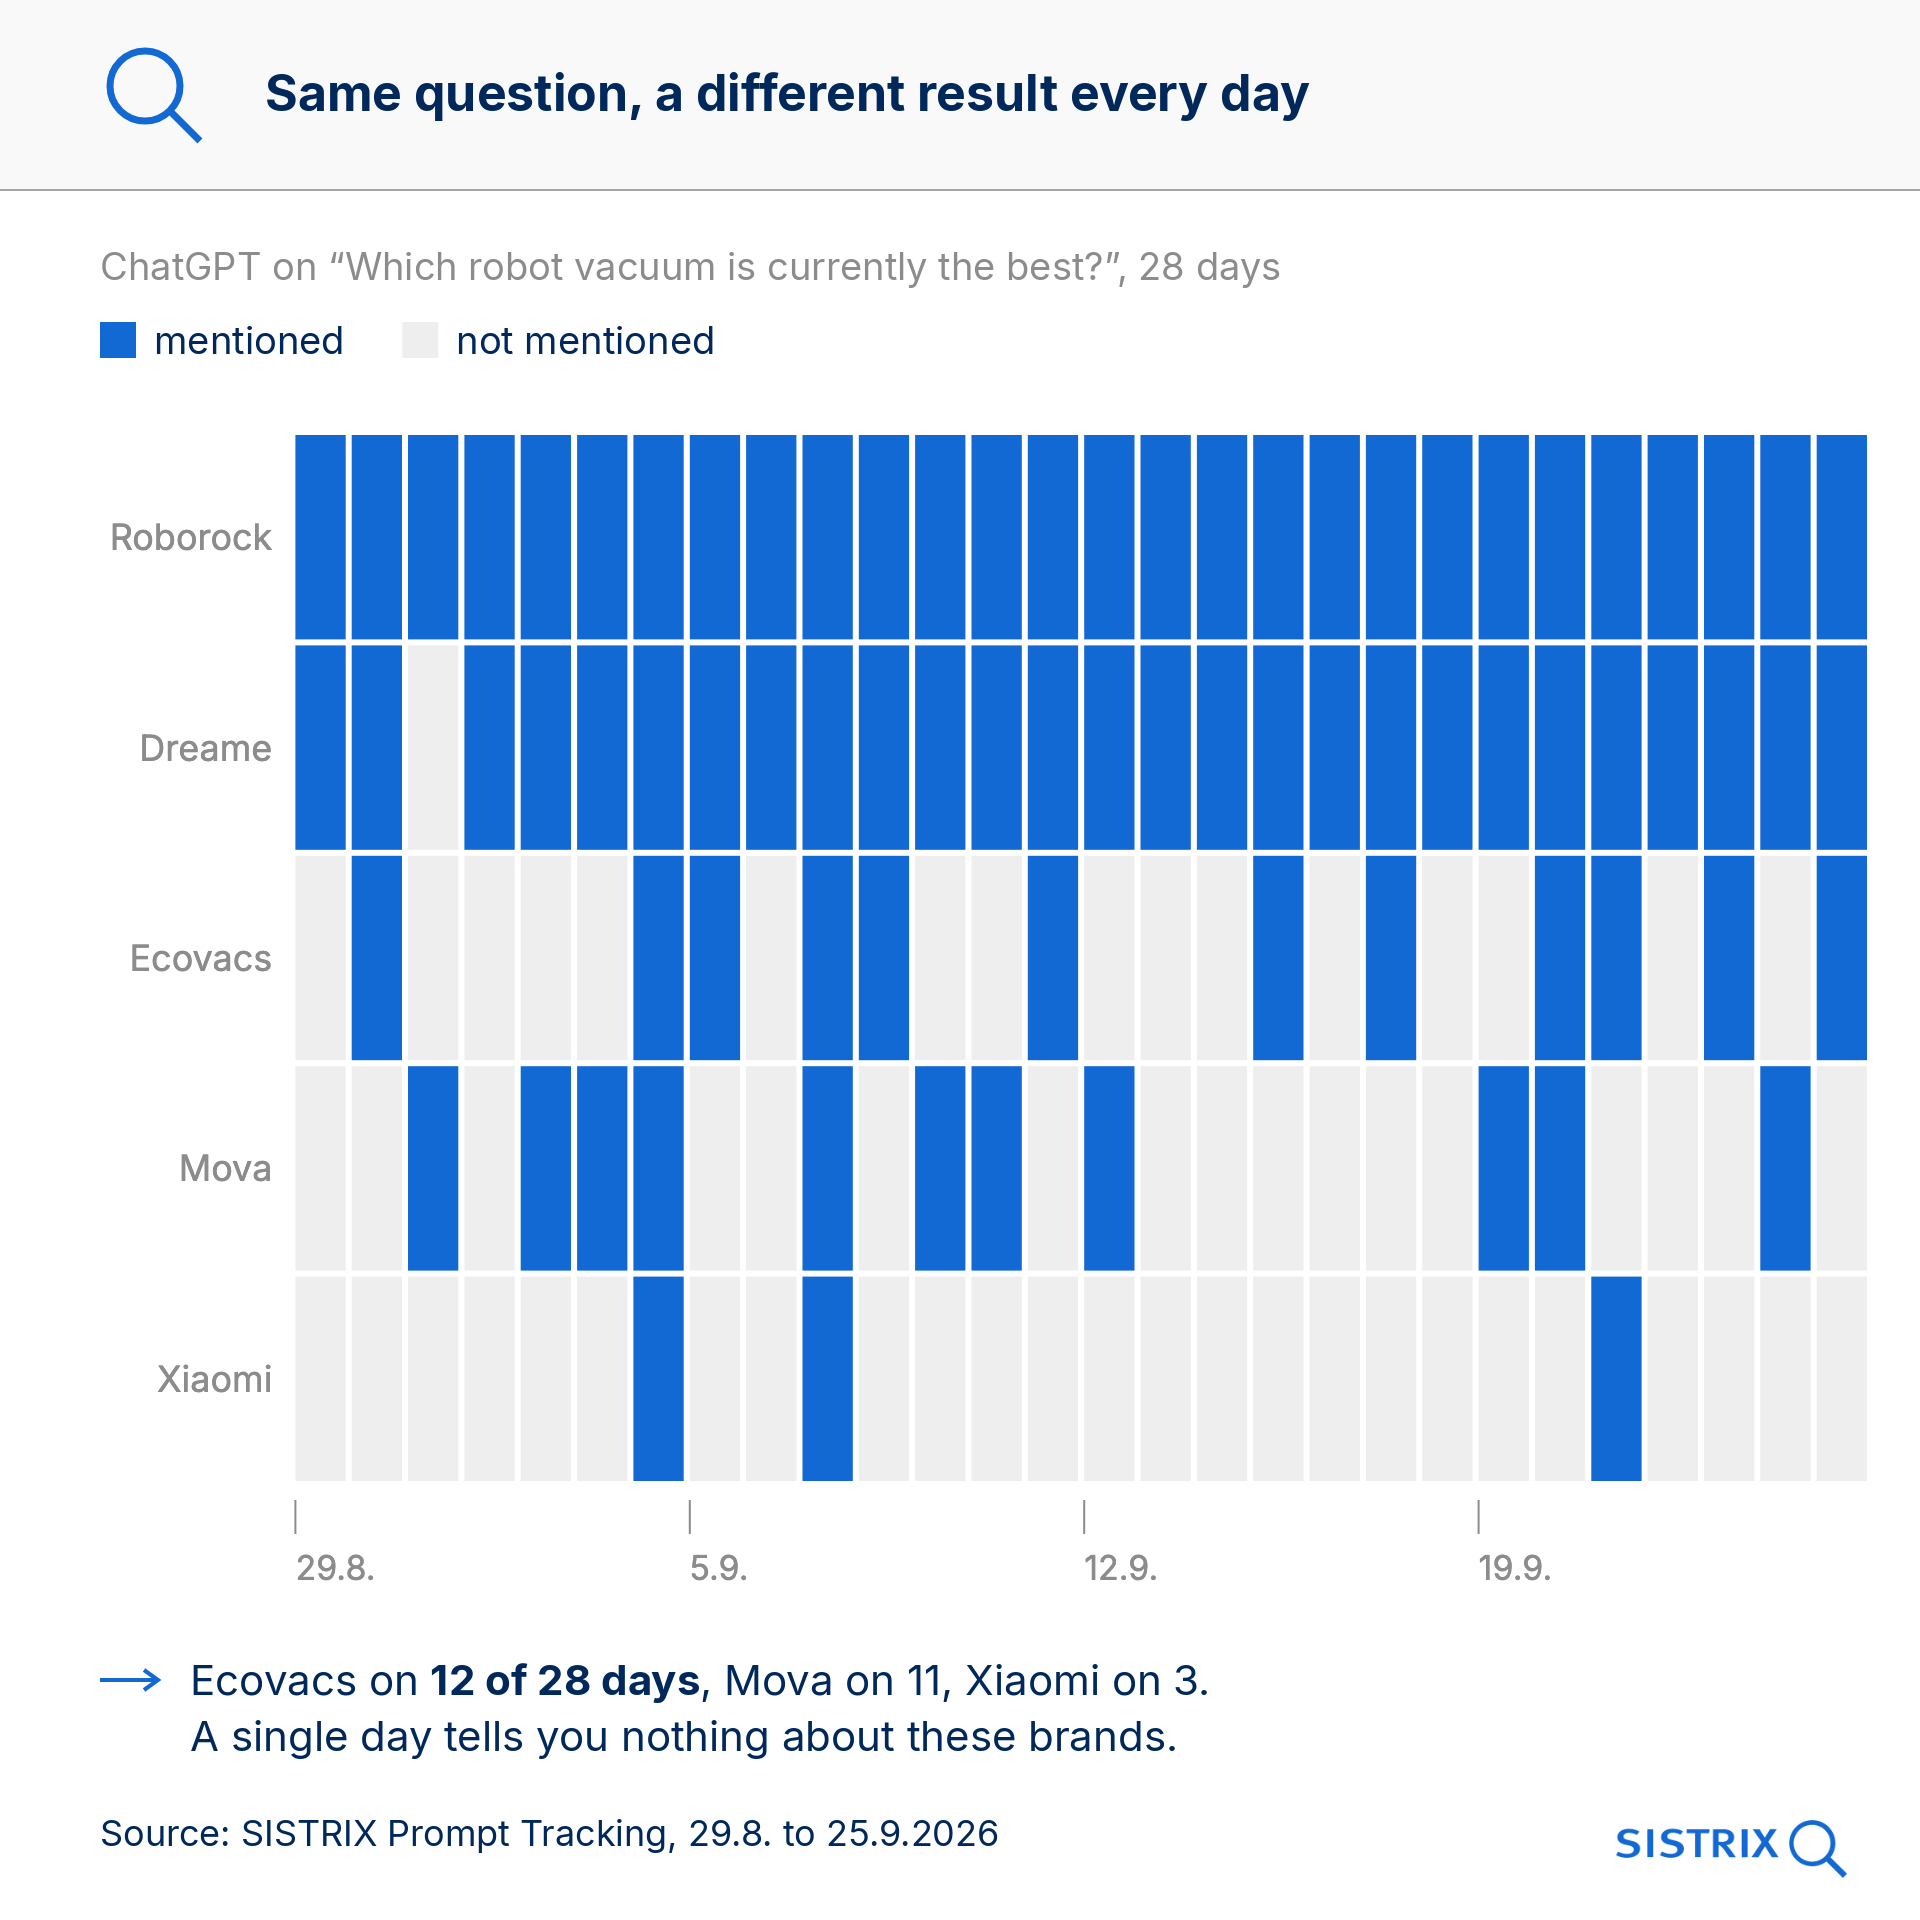
Un ejemplo de nuestro Prompt Tracking: cada día le preguntamos a ChatGPT «¿Cuál es el mejor robot aspirador ahora mismo?». Durante cuatro semanas, Roborock y Dreame aparecen casi a diario. Ecovacs aparece en 12 de 28 días, Mova en 11 y Xiaomi en 3, sin ningún patrón reconocible. Quien consulte un solo día no sabrá prácticamente nada sobre estas tres marcas.
Las respuestas individuales de la IA son realmente aleatorias
Mike King, de iPullRank, mostró recientemente en un artículo muy recomendable, titulado «There Is No “Accuracy” in AI Search Tracking – Only Precision», cuánto varían las respuestas de la IA de una ejecución a otra. Se basa en un experimento de Mike Sonders con 12 prompts y 100 ejecuciones de cada uno en ChatGPT: el 72 % de las marcas apareció en menos de una de cada cinco respuestas.
Nuestros datos lo confirman sobre una base mucho más amplia. De todas las marcas que aparecen en las respuestas a un prompt, el 70 % aparece en menos de uno de cada cinco días. Solo el 6 % está presente al menos cuatro de cada cinco días. Esto se aplica por igual a ChatGPT, AI Overviews, AI Mode y Perplexity.
Por tanto, una sola respuesta dice poco. La cuestión es cómo convertir muchas respuestas inciertas en una cifra fiable.
La pregunta clave: ¿repetir o ampliar?
Supongamos que tienes un presupuesto de 20 consultas. Puedes consultar un prompt durante 20 días, 20 prompts distintos una vez cada uno o cualquier combinación intermedia. ¿Qué reparto da la respuesta más precisa a la pregunta «¿En cuántas respuestas aparece mi marca?»?
La respuesta de las 10.826 series de medición es clara. Supongamos que una marca aparece en realidad en el 25 % de las respuestas. Si consultas un prompt durante 20 días, tu medición puede situarse en cualquier punto entre el 0 y el 59 %. Con 20 prompts distintos en un solo día, queda entre el 16 y el 35 %, y con 100 prompts, entre el 21 y el 29 %.
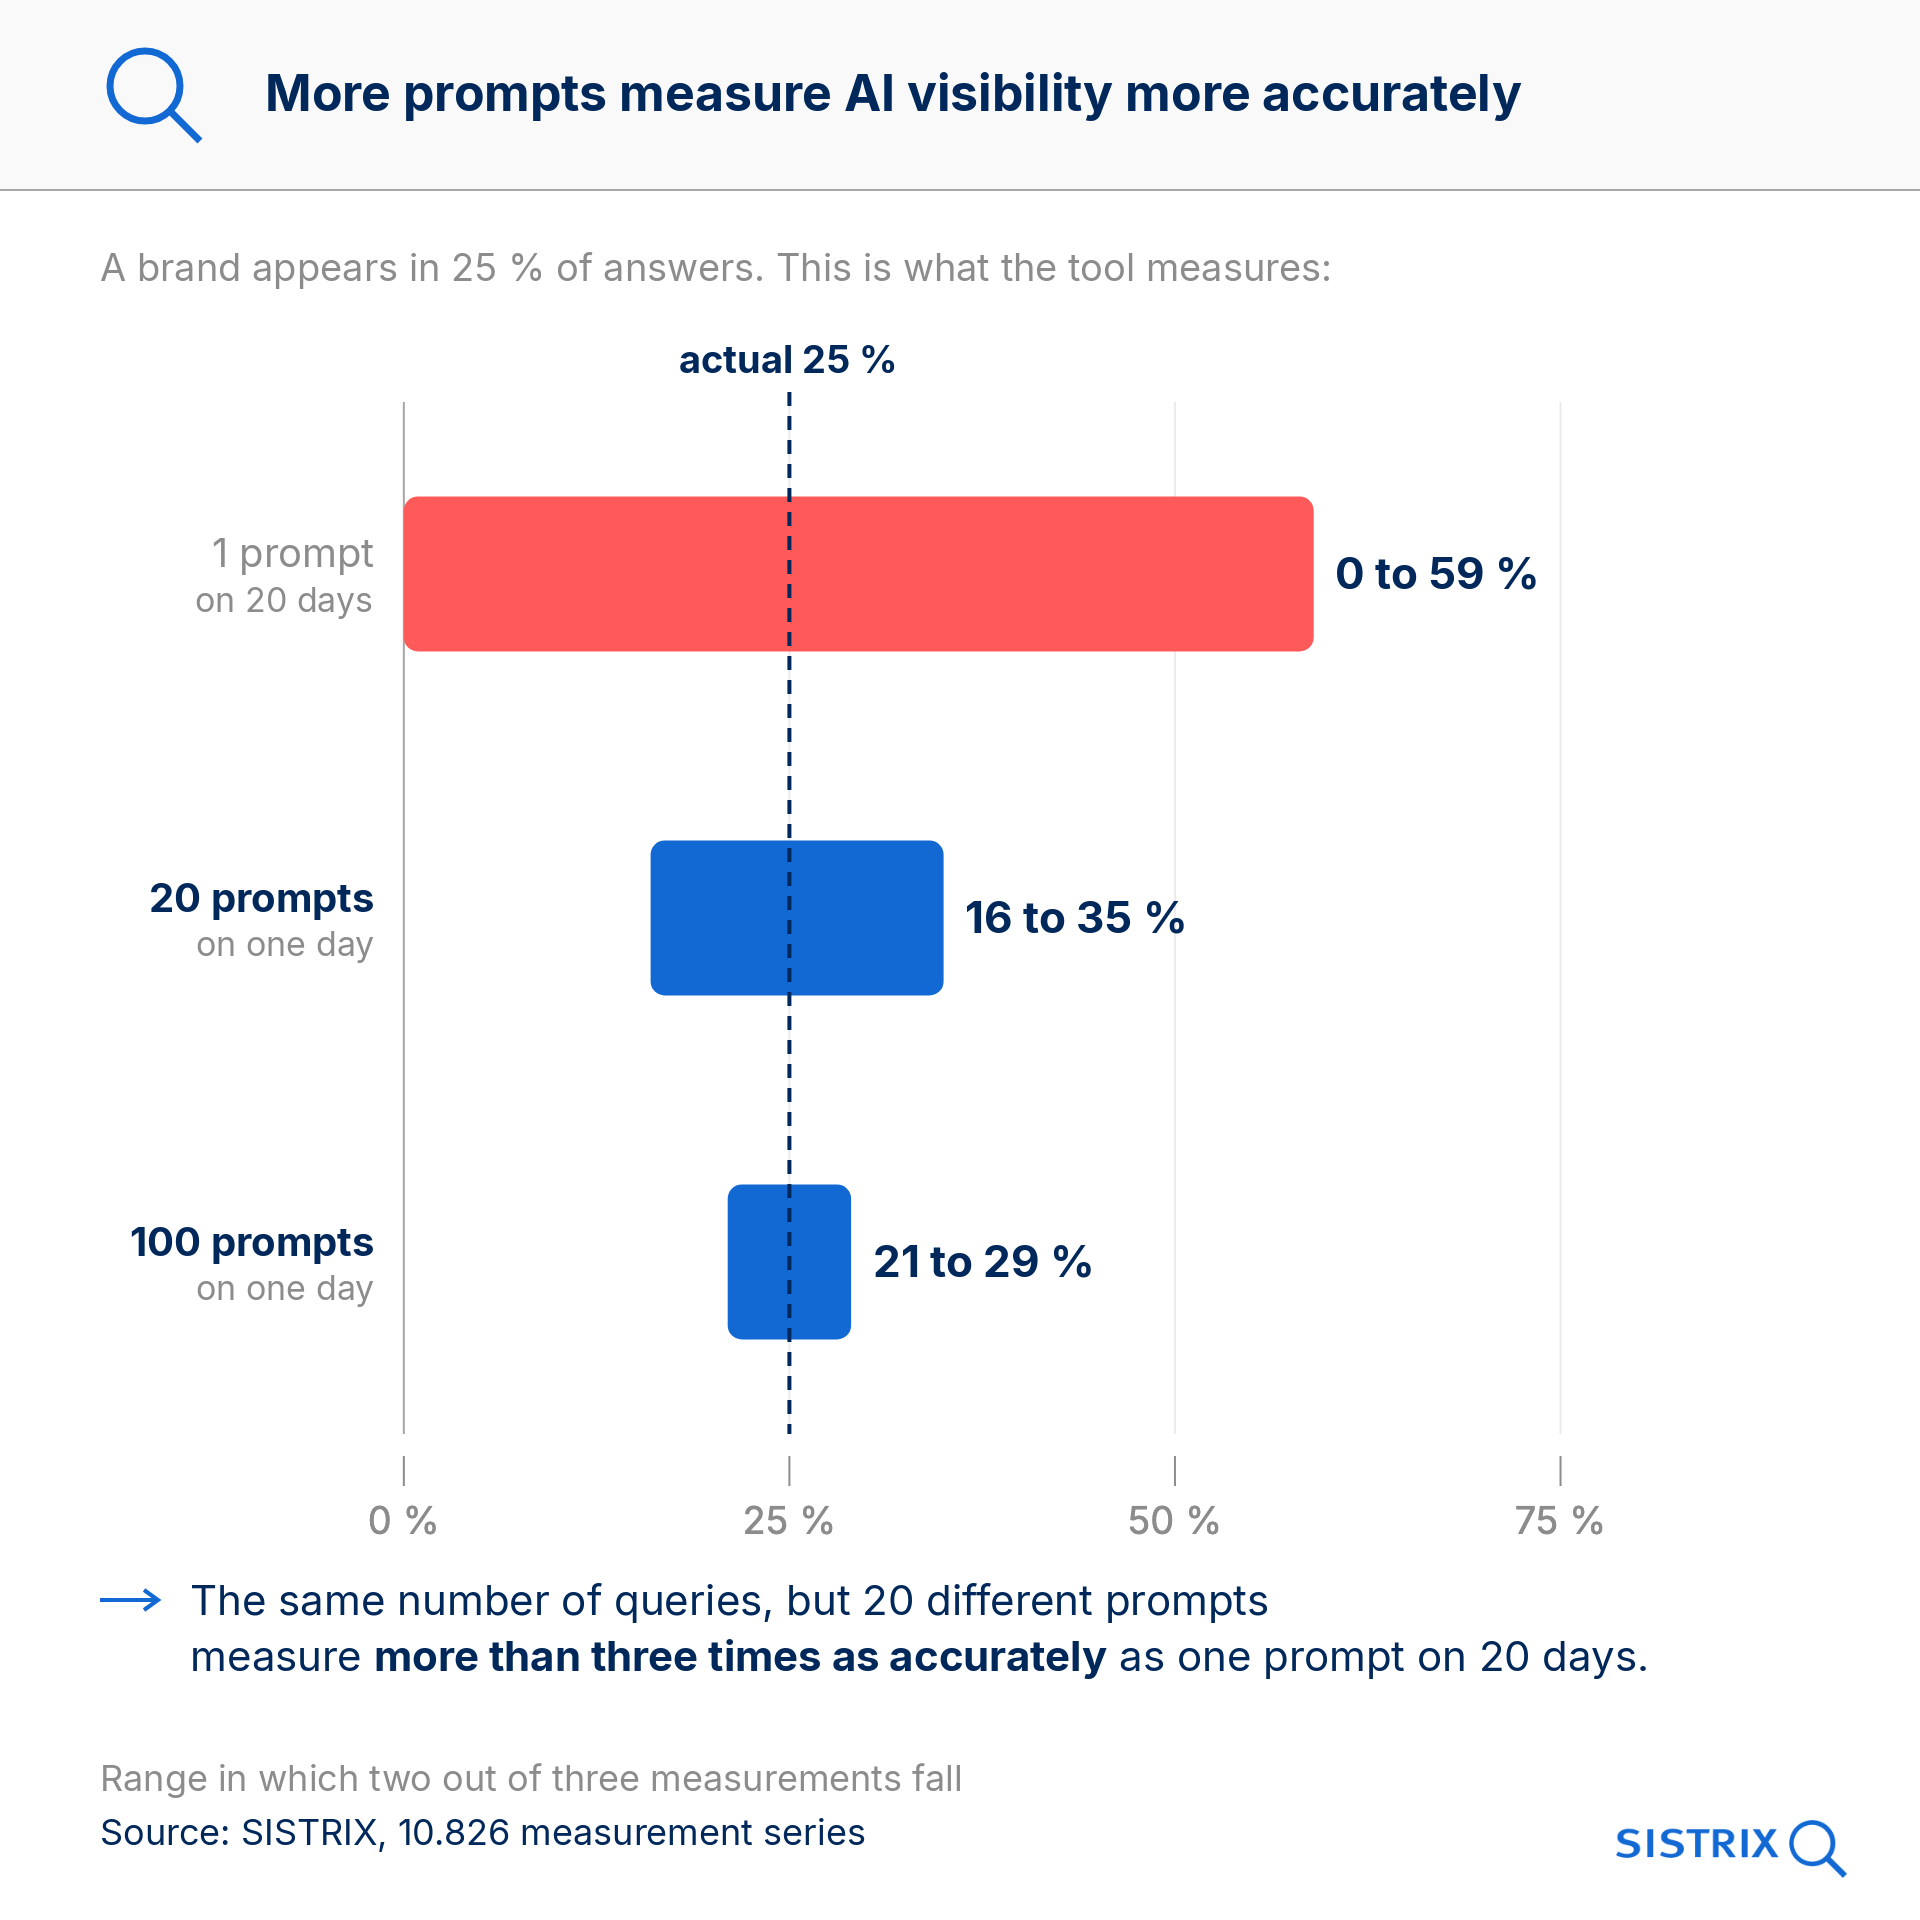
Detrás de estos rangos hay desviaciones típicas respecto al valor real: ±34 puntos porcentuales con un prompt, ±9,5 con 20 y ±4,2 con 100 prompts. Desviación típica significa que, en unos dos de cada tres casos, la medición se encuentra dentro de este rango, y en el 95 % de los casos, dentro del doble.
Con el mismo esfuerzo, medir con 20 prompts distintos es más de tres veces más preciso que medir un prompt durante 20 días. El panorama es prácticamente idéntico en los cuatro modelos y los ocho países: con 20 prompts, la desviación se sitúa en todos ellos entre ±9 y ±10 puntos.
Por qué gana la amplitud
La razón está en dos tipos de fluctuación. El mismo prompt da respuestas distintas de un día para otro. Pero prompts distintos dan respuestas todavía mucho más diferentes: en una pregunta la marca aparece casi siempre, en la siguiente casi nunca. De media, las diferencias entre prompts son 2,4 veces mayores que la fluctuación de un mismo prompt a lo largo de los días.
La repetición solo combate la menor de las dos fluctuaciones. Con 20 prompts queda un límite inferior de ±7,6 puntos, por muchas repeticiones que hagas. Para bajar de ahí solo sirven más prompts distintos.
En la práctica, esto significa que, si quieres medir la visibilidad en IA de una marca, es mejor consultar 100 prompts a la semana que 15 prompts al día. El esfuerzo es similar, pero el resultado es mucho más sólido.
Muchos prompts compensan la fluctuación
El SISTRIX AI Check muestra lo bien que funciona esto en la práctica. Para 60 marcas por país en Alemania, Estados Unidos, Reino Unido, Francia, Italia y España, hemos seguido cómo evolucionan sus cifras de una semana a otra.
De los prompts en los que se menciona una marca, cada semana cambian entre el 20 y el 55 %: la marca desaparece de algunas respuestas y aparece en otras nuevas. En ChatGPT y AI Mode es aproximadamente la mitad; en AI Overviews, uno de cada cinco prompts. Aun así, el número total de menciones suele variar en términos netos solo entre un 4 y un 10 %. Y cuantos más prompts tiene una marca, más estable es su curva. En las marcas con menos de 100 prompts, la visibilidad en IA fluctúa de una semana a otra una mediana de ±5,7 %; a partir de 10.000 prompts, solo ±1,9 %.
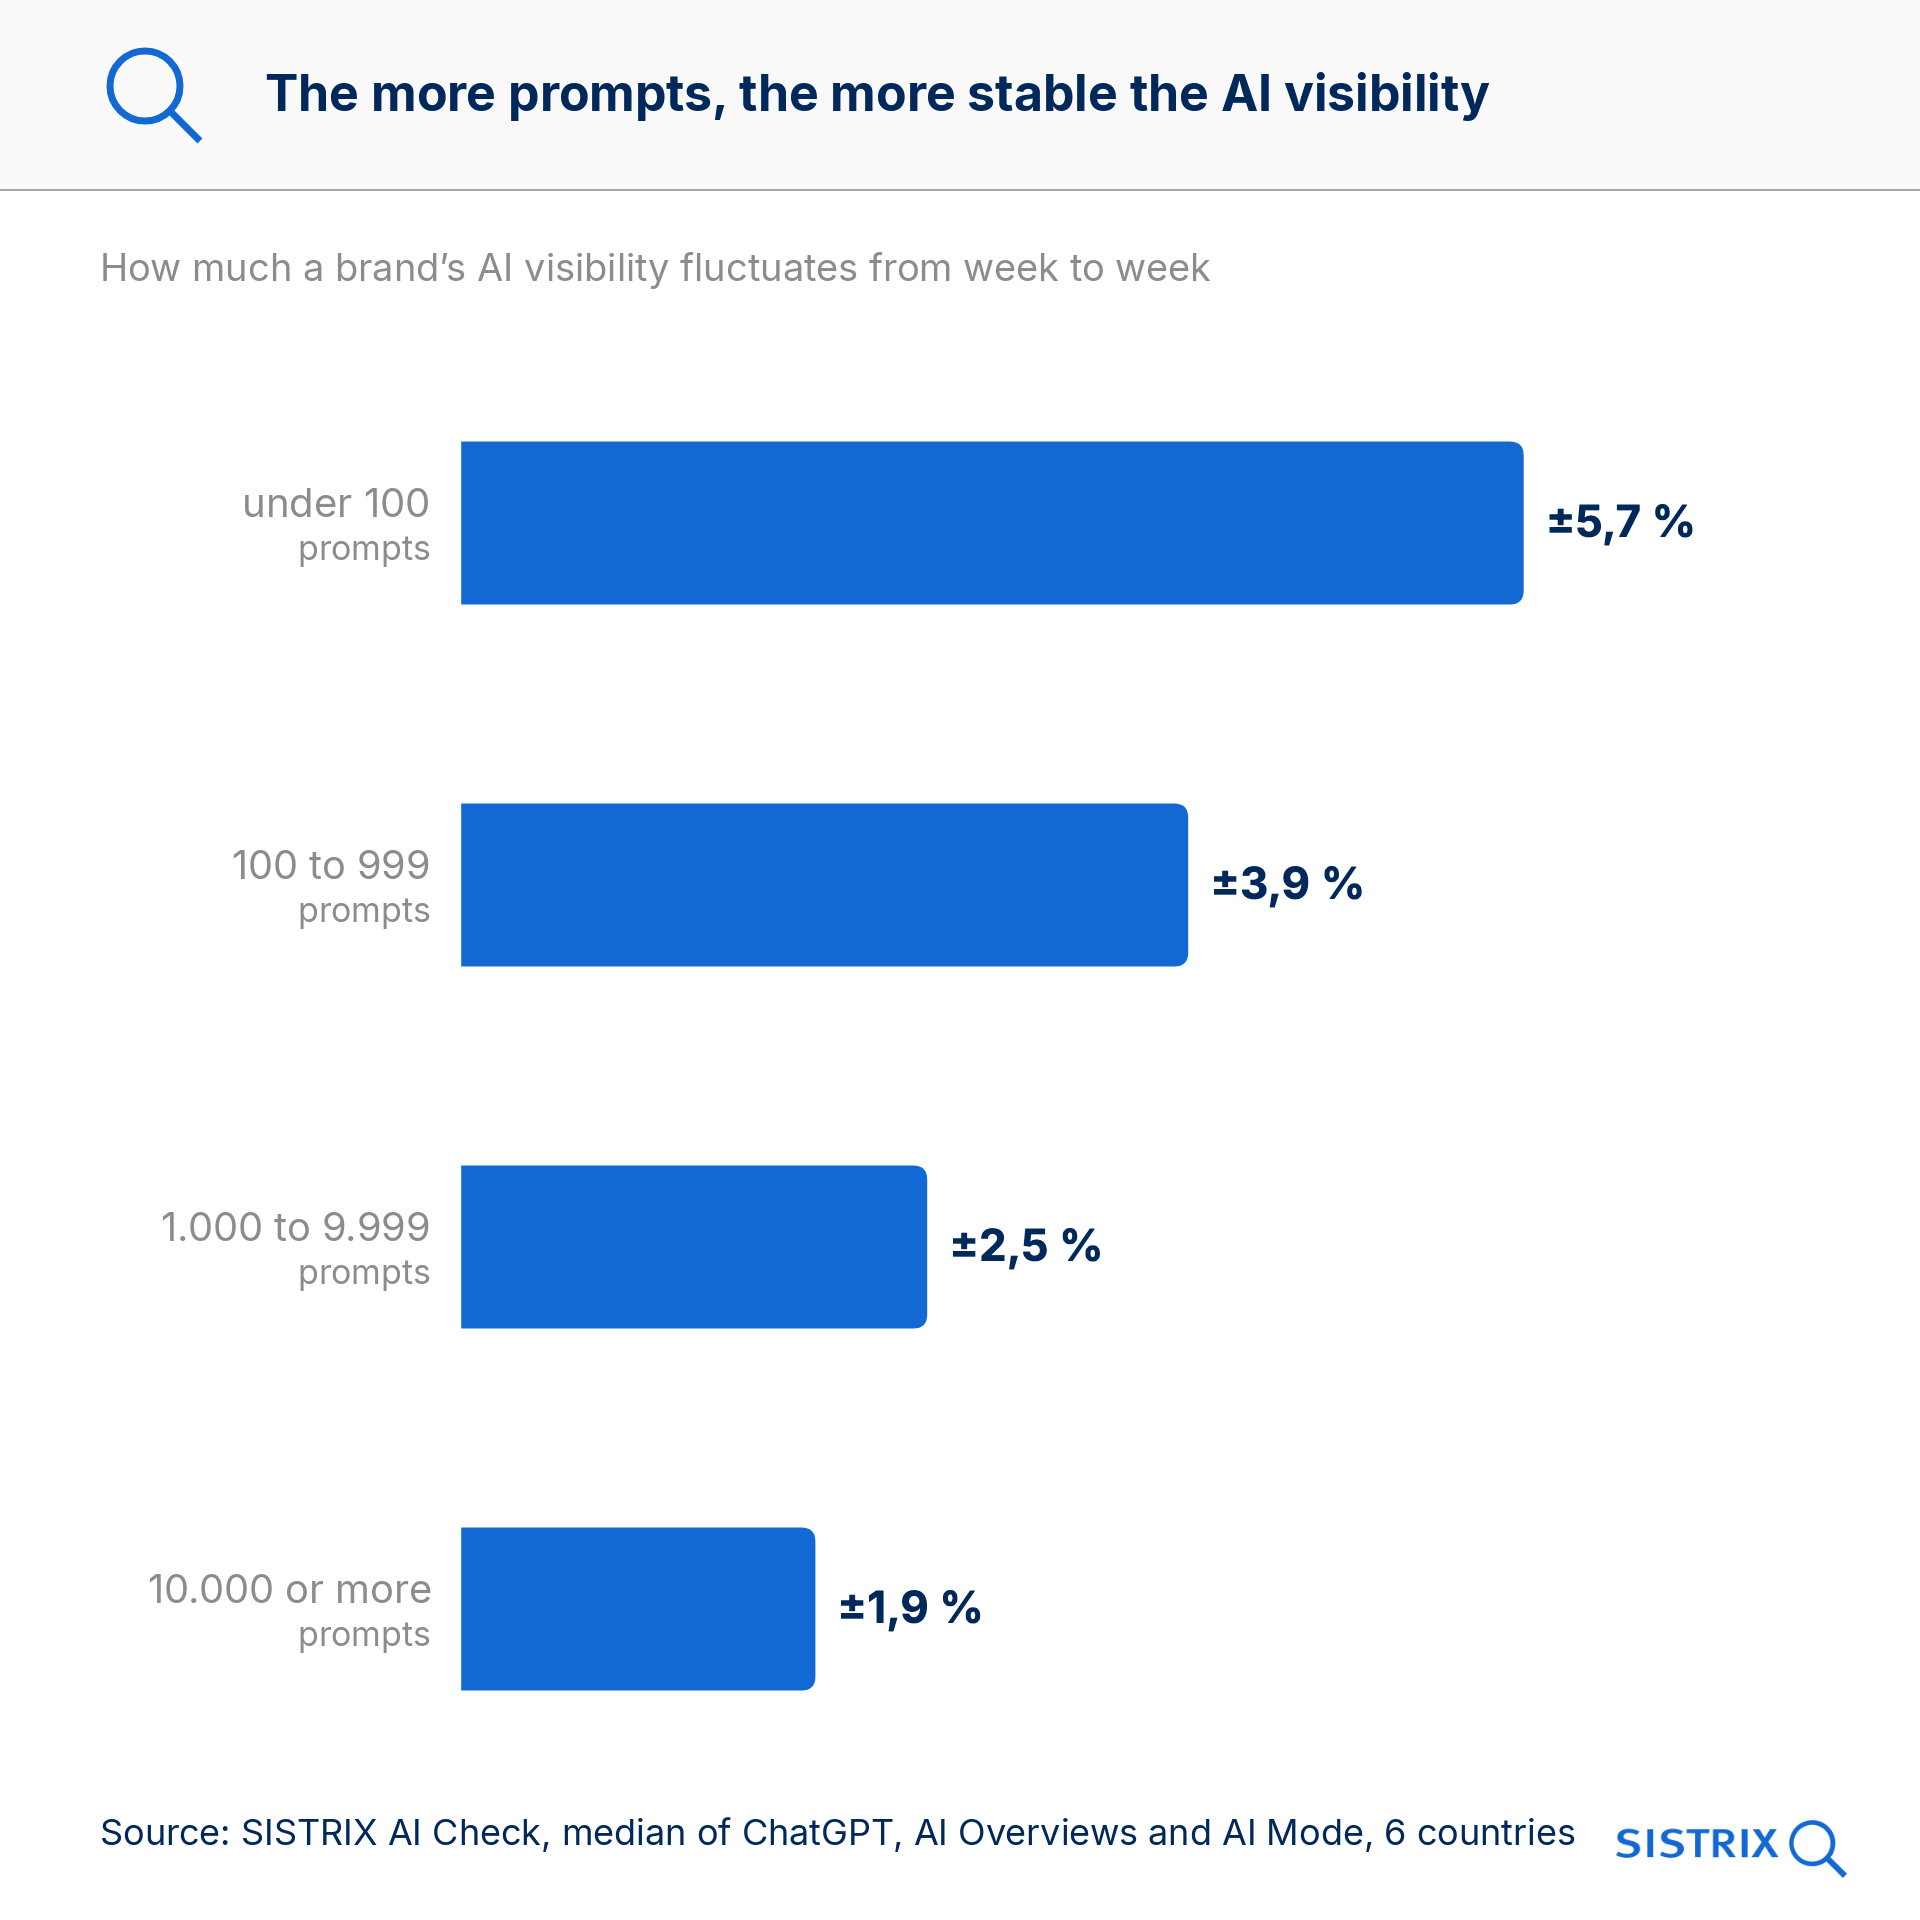
Lo que medimos es la desviación respecto a la tendencia propia de cada marca, descontando los cambios en el conjunto total de prompts. La única excepción son las marcas muy grandes en AI Overviews, con ±3,1 %: ahí los cambios en el conjunto de prompts pesan más que el azar de las respuestas.
Las respuestas individuales fluctúan mucho, pero la cifra calculada sobre muchos prompts se mantiene estable. Ese es precisamente el efecto que se necesita para una medición fiable.
Cuándo siguen teniendo sentido las consultas diarias
En un punto iPullRank tiene razón: la repetición no carece de valor. Solo que sirve para responder a otra pregunta.
«¿Qué visibilidad tengo?» se responde con amplitud. «¿Ha cambiado algo?» se responde con repetición. Si el conjunto de prompts se mantiene igual, la diferencia entre prompts desaparece en la comparación y solo queda la fluctuación de un día a otro. Con 20 prompts, el valor diario tiene una precisión de ±4,8 puntos y la media semanal, de ±1,8 puntos.
Así que, si después de una acción quieres saber si algo ha cambiado, no compares días sueltos, sino medias semanales. La media diaria de 20 prompts suele variar entre 4 y 5 puntos, y uno de cada diez días, 10 puntos o más, sin que haya cambiado nada.
Por eso muchas herramientas promedian los valores diarios en una ventana móvil de 7 días. Para detectar cambios tiene sentido, pero para el nivel aporta poco. Medidos durante siete días, 20 prompts tienen una precisión de ±7,9 puntos, apenas mejor que en un solo día (±9,5). Ni siquiera con un número ilimitado de días se baja de ±7,6, porque la ventana solo compensa la fluctuación diaria, no la selección de prompts. En cambio, las mismas 140 consultas repartidas en 140 prompts distintos en un solo día alcanzan ±3,6 puntos.
Preciso no es lo mismo que exacto
iPullRank distingue entre precisión (¿cuánto se dispersa una medición?) y exactitud (¿coincide con el valor real?) y llega a la conclusión de que en la visibilidad en IA no existe un valor real con el que medir la exactitud.
Nosotros lo vemos de otra manera. Si se define el valor real como la tasa de menciones en el conjunto de todos los prompts de un mercado, tal como lo refleja el AI Check, la exactitud sí se puede medir. Y resulta ser la mayor fuente de error.
Hemos comparado la visibilidad de marcas en conjuntos de prompts elegidos por ellas mismas con su visibilidad en el AI Check, en ambos casos como cuota frente a sus competidores. Si no hubiera efecto de selección, el conjunto propio quedaría unas veces por encima y otras por debajo, es decir, saldría mejor en aproximadamente la mitad de los casos. En realidad, la propia marca sale mejor parada en tres de cada cuatro casos, casi siempre con claridad. Según qué competidores se tomen como referencia, la cifra oscila entre el 63 y el 80 %.
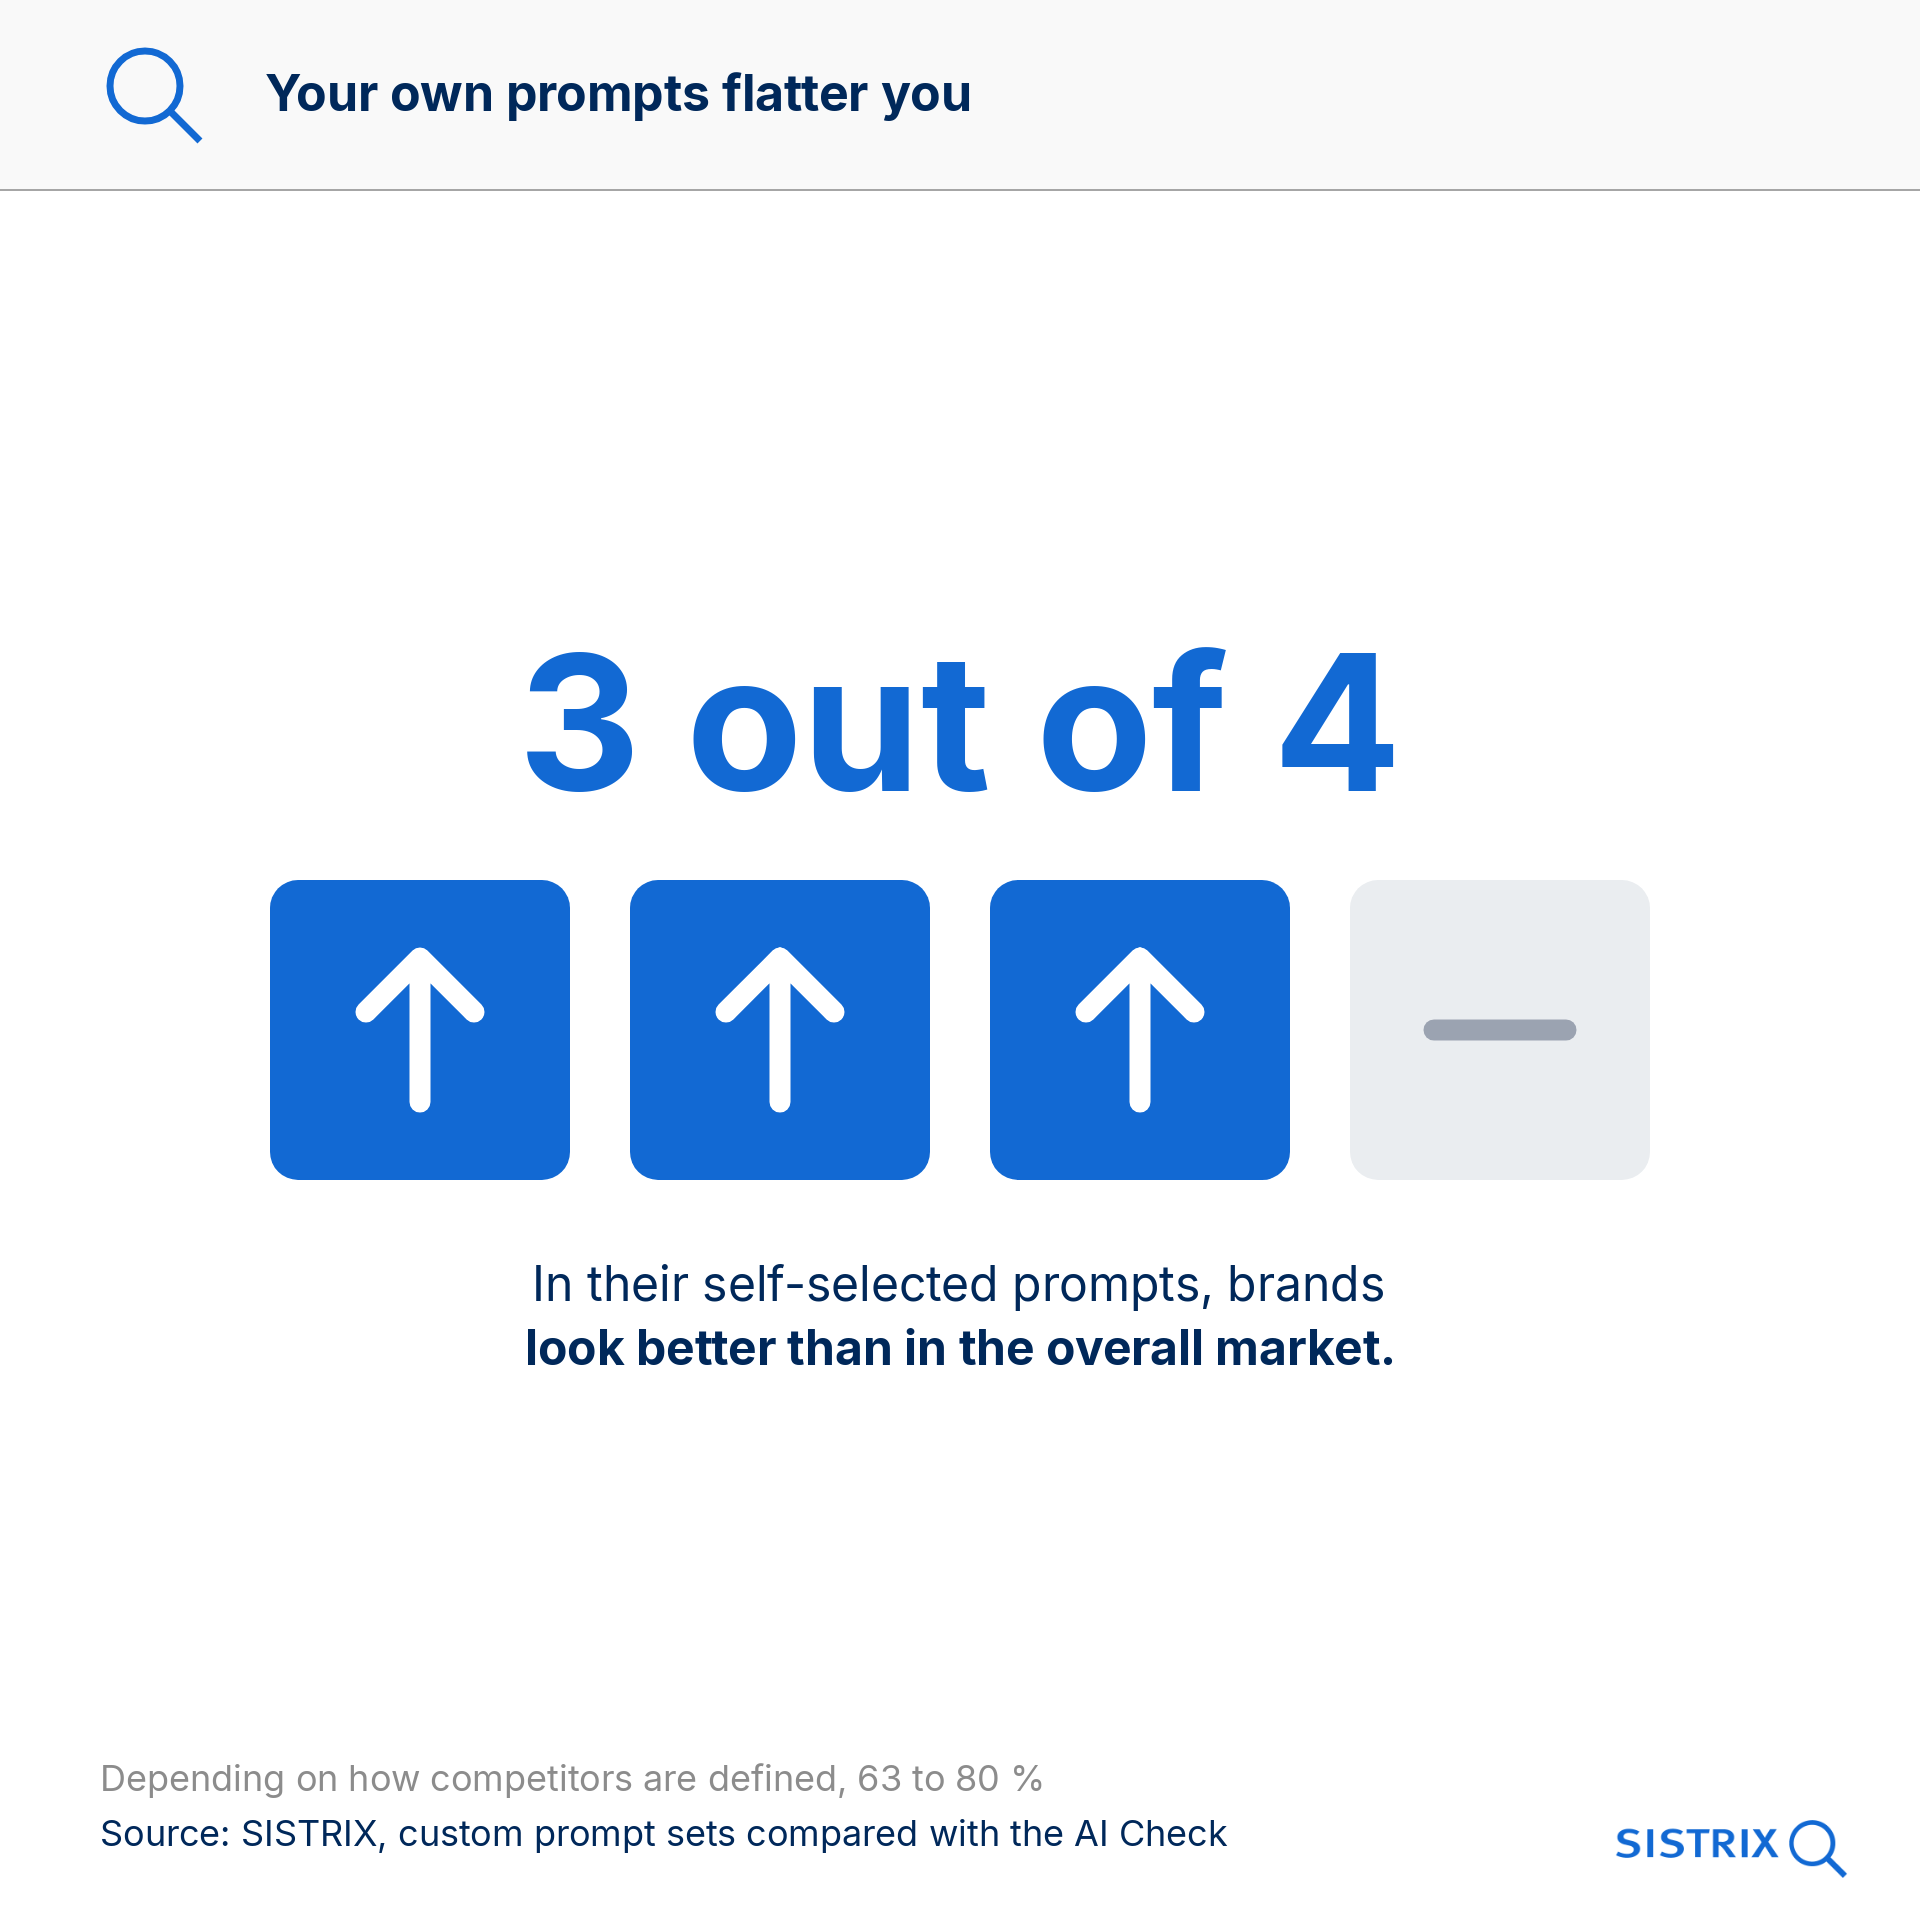
No es un error de medición, sino un efecto de selección. Quien elige sus propios prompts escoge preguntas cercanas a su propia marca. El instrumento es preciso, pero apunta mal, como el segundo jugador de dardos de la imagen del artículo de iPullRank.
En el conjunto propio: estable para tu marca, incierto para la competencia
Un último hallazgo matiza la imagen de la «tirada de dados». En los conjuntos de prompts elegidos por la propia marca, esta solo se desvía de su resultado habitual en el 6 % de las ejecuciones diarias. La mayoría de los prompts la mencionan casi siempre o casi nunca.
Esto también se debe a la selección: si eliges los prompts en torno a tu propia marca, mides bien tu marca y a todas las demás solo de forma marginal. Por eso, lo más incierto son las afirmaciones sobre competidores y marcas secundarias, es decir, ese 70 % que solo aparece algunos días. Si a partir de un conjunto de prompts propio y pequeño deduces que un competidor ha crecido, ten cuidado. Para compararse con la competencia es mejor un conjunto de prompts que no se haya seleccionado en función de una marca.
Qué significa esto
Cinco recomendaciones para quien mida la visibilidad en IA:
- Más prompts en lugar de más ejecuciones. Para la pregunta «¿Qué visibilidad tengo?», el número de prompts distintos es la palanca decisiva. Con 20 prompts solo se obtiene una estimación aproximada (±10 puntos). Para ±5 puntos se necesitan unos 70 prompts y para ±3 puntos, unos 200. Como regla general: para reducir la incertidumbre a la mitad, necesitas cuatro veces más prompts.
- Una vez a la semana basta para la amplitud. Un conjunto de prompts grande consultado semanalmente es más fiable que uno pequeño consultado a diario. Con el mismo número de consultas, 140 prompts una vez a la semana tienen una precisión de ±3,6 puntos, mientras que 20 prompts diarios con una ventana de 7 días solo llegan a ±7,9. Si tienes presupuesto, inviértelo en más prompts, no en consultas más frecuentes.
- Evaluar los cambios con medias semanales. Los valores diarios saltan entre 5 y 10 puntos sin motivo. Si con un conjunto de prompts fijo quieres saber si una acción funciona, compara medias semanales. Con 20 prompts, su incertidumbre es de ±1,8 puntos, frente a ±4,8 en un solo día.
- Medir el nivel en el mercado y los cambios en el conjunto propio. Los prompts elegidos por uno mismo muestran las tendencias de forma fiable, pero suelen dar un nivel absoluto demasiado favorable. Para saber qué visibilidad tiene realmente tu marca, un conjunto amplio de prompts como el SISTRIX AI Check es más adecuado que cualquier conjunto propio. Lo más significativo ahí son las cuotas como el Share of Voice, porque compensan los cambios en el conjunto total.
- Interpretar con cautela las cifras de la competencia en el conjunto propio. Un conjunto de prompts elegido por uno mismo está hecho a medida de la propia marca. Los competidores solo aparecen de forma marginal y fluctúan mucho más. En el AI Check no ocurre esto: allí todas las marcas se miden igual, y la estabilidad de su cifra depende únicamente de en cuántos prompts aparecen.
De ahí se deriva un reparto de tareas sencillo. La visibilidad real de una marca se ve al analizar muchísimos prompts que no se han seleccionado en función de ella: en el AI Check, la visibilidad en IA de las marcas con más de 1.000 prompts solo fluctúa entre ±1 y 3 % por semana. Si una acción funciona, lo muestra un conjunto fijo de prompts en Prompt Tracking, consultado a diario y promediado por semanas. Quien separa ambas cosas obtiene una cifra correcta y una curva que muestra los cambios de forma fiable.