
¿Qué páginas citan ChatGPT y el AI Mode y los AI Overviews de Google, y qué tienen en común? Hemos analizado 96.418 URLs y comprobado qué recomendaciones de GEO resisten el contraste con un gran conjunto de datos.
- Lo que funciona: estructura para la máquina, confianza para las personas
- Estructura: índice de contenidos, schema Article y FAQ
- Confianza: caja de autor, fecha de actualización, fuentes
- Actualidad: el año en el título
- En conjunto: 2,1 veces más citaciones
- Todos los factores de un vistazo
- ¿Qué aporta menos de lo esperado?
- llms.txt: sin ventaja medible
- No todo el schema es igual
- Legibilidad: importante para las personas, neutral para la IA
- Número de palabras: síntoma, no causa
- Plataformas y tipos de dominio: mismos principios, distinta ponderación
- Conclusión: lo que puedes aplicar desde mañana
- Cómo hemos medido
- FAQ: preguntas frecuentes sobre el estudio de Citation Worthiness
Consejos sobre GEO hay a montones, pero datos sólidos que los respalden, bastantes menos. Muchas recomendaciones se basan en experimentos de laboratorio, casos de estudio con unos cientos de URLs o listas top 100 que, sobre todo, miden la fuerza de marca. Hasta qué punto los conjuntos de datos pequeños pueden llevar a engaño lo hemos comprobado nosotros mismos: en nuestras pruebas, el efecto del schema FAQ se invirtió por completo a medida que crecía la muestra.
Por eso, para el estudio de Citation Worthiness hemos analizado un gran volumen de datos: 48.527 páginas del AI Index de SISTRIX para la región DACH que fueron citadas por ChatGPT, el AI Mode o los AI Overviews, cada una comparada directamente con una página no citada del mismo dominio. Los resultados más importantes, de un vistazo:
TL;DR
- Una vez en la plantilla: incluye un índice de contenidos, schema Article, una caja de autor con foto y, sobre todo en contenidos editoriales, una fecha de actualización visible.
- En cada página: añade un bloque de preguntas frecuentes con schema, un TL;DR, una pregunta como encabezado H2, una tabla y referencias a fuentes allí donde encaje con el contenido.
- A nivel estratégico: conoce tu tipo de dominio, mantén los contenidos actualizados y, si tienes una tienda online, crea una sección de guías.
- Lo que te puedes ahorrar: priorizar el llms.txt, tratar el schema como una solución milagrosa, estirar los textos hasta un número de palabras concreto y fiarte de estudios con menos de 5.000 URLs.
- El efecto: las páginas que combinan muchas de estas características se citan 2,1 veces más que las apenas optimizadas.
Cómo hemos medido y dónde están los límites del estudio lo explicamos más abajo.
Ten en cuenta: este estudio se basa en datos del mercado germanohablante (región DACH: Alemania, Austria y Suiza). Los resultados pueden variar en otros países e idiomas.
Lo que funciona: estructura para la máquina, confianza para las personas
Casi todas las señales positivas responden a dos principios:
- Facilitar a los modelos de IA la extracción del contenido, por ejemplo con un índice de contenidos, schema Article y FAQ, preguntas como subtítulos, tablas y listas.
- Demostrar que detrás del contenido hay una persona que lo mantiene, por ejemplo con una caja de autor, una fecha de actualización y referencias a fuentes.
Antes de entrar en cada característica, una nota rápida sobre cómo leer las cifras: todos los resultados se expresan como factor. Un factor de 1,7 para el índice de contenidos significa que, de dos páginas del mismo dominio, la que tiene índice se cita 1,7 veces más que la que no lo tiene. Un factor de 1,0 significa que no hay diferencia, y los valores por debajo se asocian a menos citaciones.
Estructura: índice de contenidos, schema Article y FAQ
Ninguna señal estructural se asocia a más citaciones que el índice de contenidos: las páginas con un índice visible y enlaces de anclaje se citan 1,7 veces más. Sin embargo, solo el 14 % de las páginas tiene uno. Las páginas con schema Article se citan 1,6 veces más, y en la mayoría de los CMS este marcado se activa con un simple ajuste. Las páginas con schema FAQPage se citan 1,5 veces más, en las tres plataformas y en todos los tipos de dominio salvo las enciclopedias, a pesar de que Google ha eliminado los resultados enriquecidos de FAQ. La condición es que sean preguntas reales y no FAQs de relleno.
A esto se suman señales estructurales más pequeñas: al menos cinco encabezados H2 (1,6), tablas con fila de encabezado (1,5), diez o más listas de viñetas por página (1,5), al menos una pregunta como encabezado H2 (1,4) y un resumen TL;DR al principio (1,3). No obstante, el valor del número de encabezados H2 hay que tomarlo con cautela, ya que los textos más largos tienen casi automáticamente más subtítulos. Con las preguntas como encabezado es distinto: su efecto no depende de la longitud del texto.
Confianza: caja de autor, fecha de actualización, fuentes
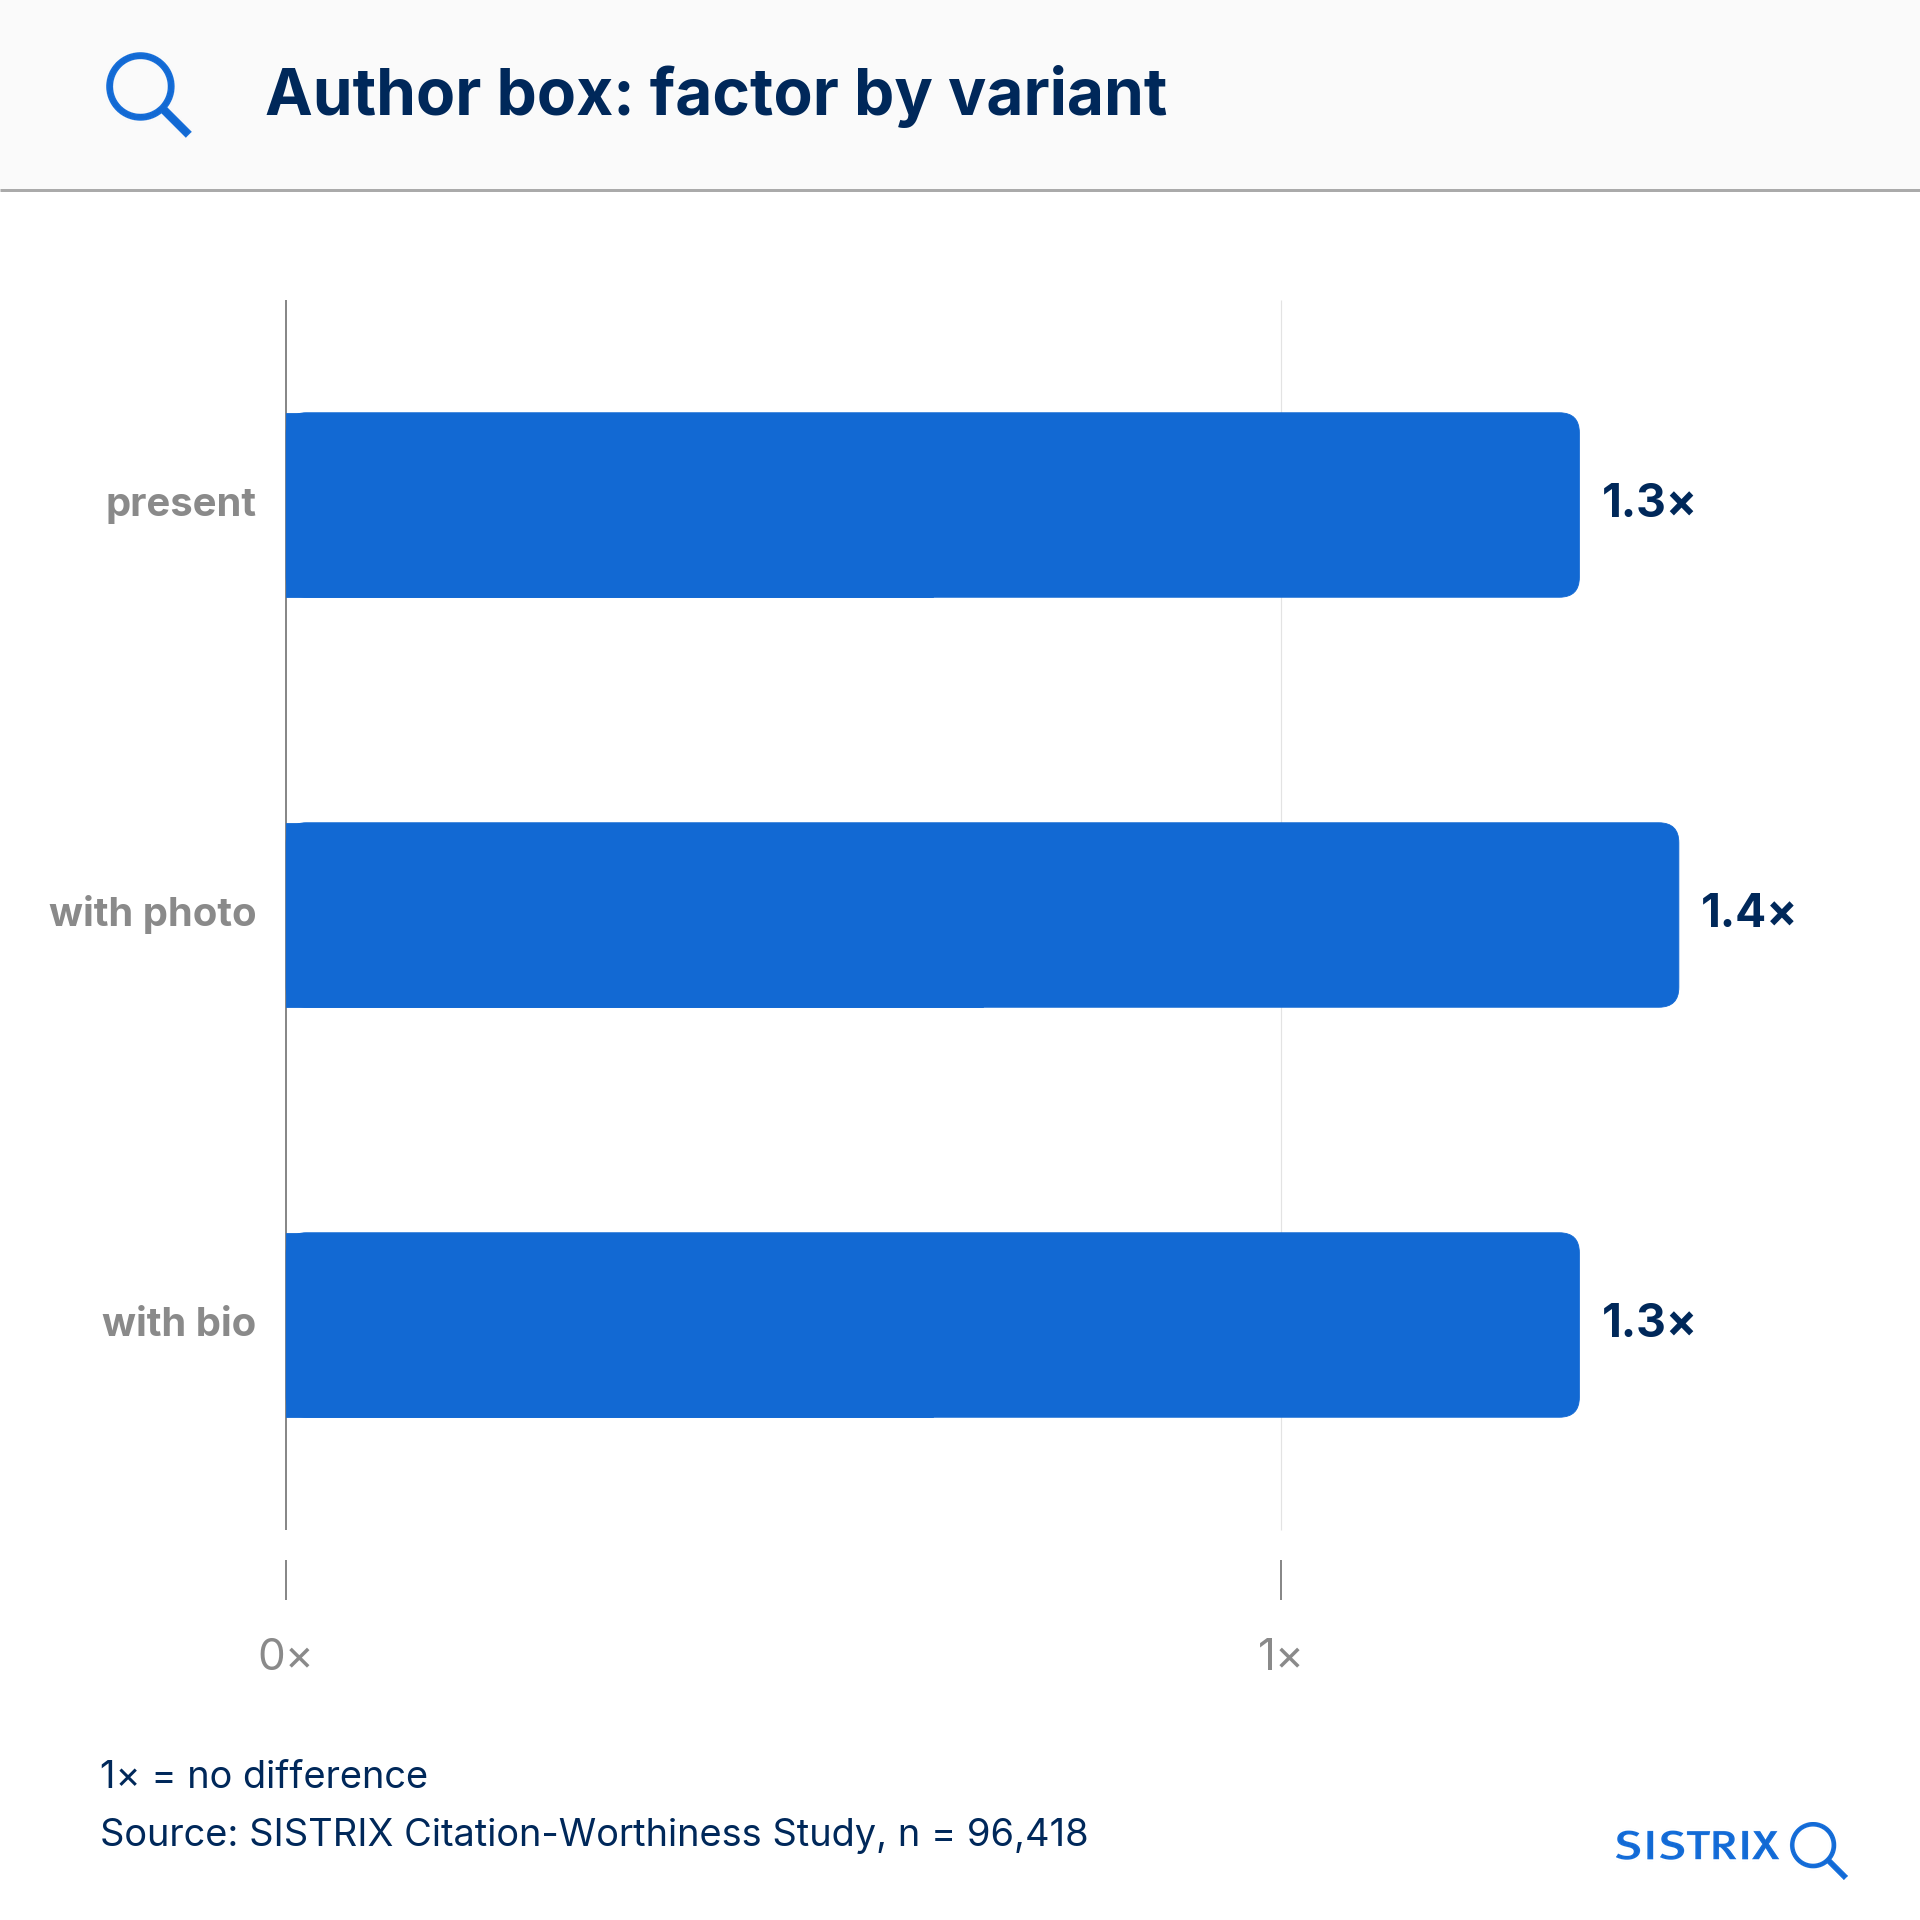
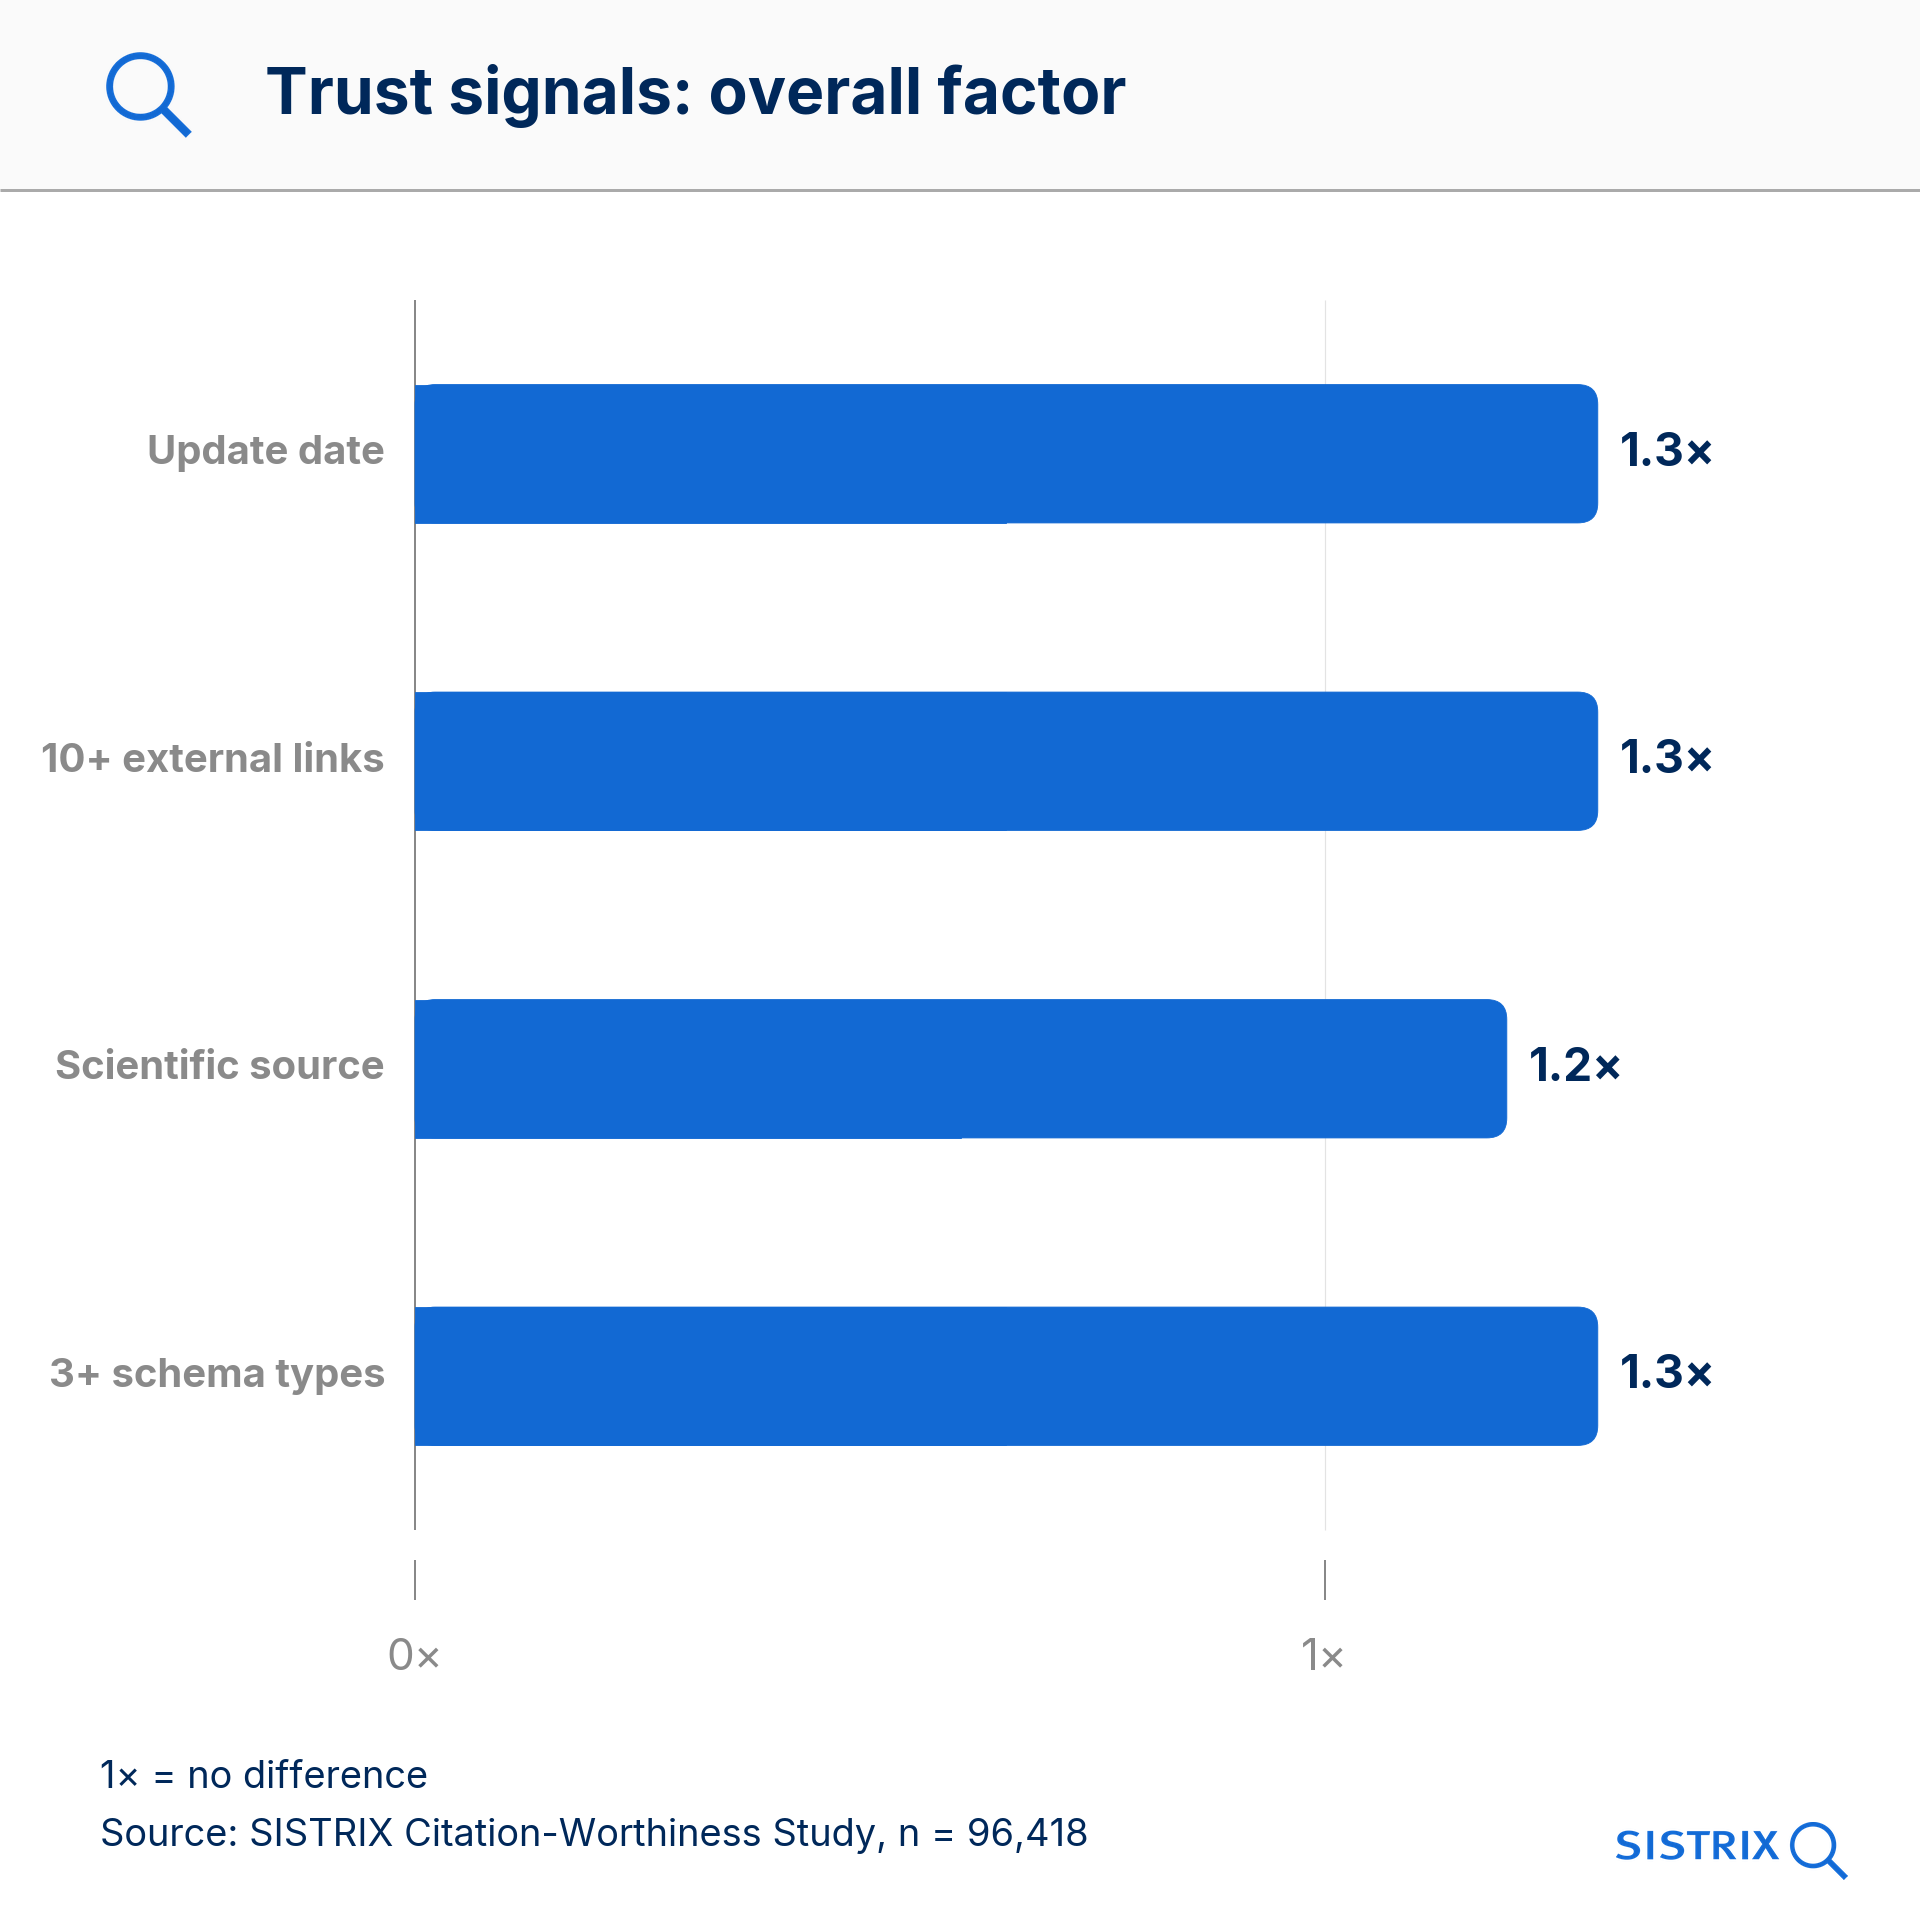
Las páginas con caja de autor y foto se citan 1,4 veces más. No hace falta mucho: nombre, foto, dos frases sobre la experiencia del autor y schema Person. Las páginas con una fecha de actualización visible, al menos diez enlaces externos o al menos tres tipos distintos de datos estructurados se citan, en cada caso, 1,3 veces más. Ahora bien, solo el 5 % de las páginas muestra una fecha de actualización, y su efecto depende del tipo de dominio. Más sobre esto a continuación.
Actualidad: el año en el título
El valor más alto del estudio lo alcanza el año actual en el título: las páginas con 2025 o 2026 en el título se citan 2,7 veces más, mientras que las que solo incluyen un año anterior se quedan en un factor de 0,7. Pero ojo, no es un truco de título. El año es un indicador de contenidos creados o actualizados recientemente. Los datos no permiten saber si basta con cambiar solo el año. Además, esta característica no formaba parte del análisis planificado inicialmente, sino que se añadió después. Por eso, el valor es más bien un primer indicio que un resultado consolidado.
En conjunto: 2,1 veces más citaciones
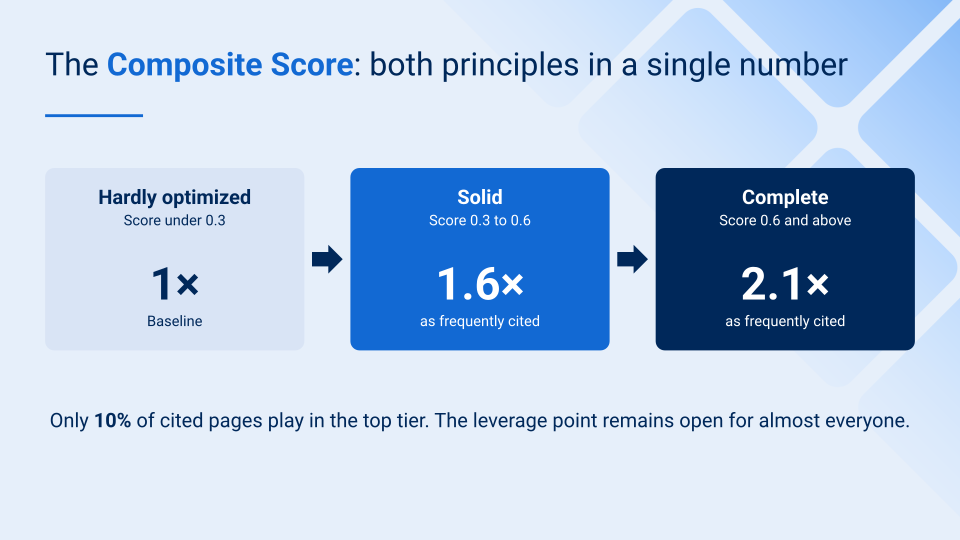
Por separado, la mayoría de las señales tienen un efecto moderado, pero juntas marcan una diferencia clara. Para comprobarlo, hemos creado una puntuación global a partir de once de las características. Las páginas que cumplen muchas de ellas se citan 2,1 veces más que las apenas optimizadas, y las páginas de la zona media, 1,6 veces más. Solo el 10 % de las páginas citadas cumple ya muchas de las características, así que casi todas tienen todavía margen de mejora.
Todos los factores de un vistazo
| Feature | Citation factor |
|---|---|
| Current year in the title* | 2.7 |
| Table of contents | 1.7 |
| Article schema | 1.6 |
| At least five H2 headings | 1.6 |
| FAQPage schema | 1.5 |
| Table with a header row | 1.5 |
| Bullet lists (ten or more per page) | 1.5 |
| At least 1,000 words | 1.5 |
| Author box with photo | 1.4 |
| At least one question as an H2 | 1.4 |
| H1 with at least five words* | 1.4 |
| Visible last-updated date | 1.3 |
| At least three schema types | 1.3 |
| At least ten external links | 1.3 |
| TL;DR at the beginning | 1.3 |
| Title phrased as a question* | 1.3 |
| Title with at least 45 characters* | 1.3 |
| Meta description | 1.2 |
| Scientific source | 1.2 |
| Numbered lists | 1.2 |
| Expandable details blocks | 1.2 |
| At least 100 internal links | 1.2 |
| Title with a colon* | 1.2 |
| Images in the main content | 1.1 |
| Good readability (Flesch index) | 1.03 (not significant) |
| Breadcrumb, HowTo and QAPage schema | 1.0 |
| Title consisting only of the H1 plus a brand suffix* | 0.9 |
| Product schema | 0.8 |
| Only an older year in the title* | 0.7 |
| Recipe schema | 0.1 |
Un factor de 1,0 significa que no hay diferencia. * Las características de título y H1 se analizaron a posteriori y deben entenderse como primeros indicios.
¿Qué aporta menos de lo esperado?
llms.txt: sin ventaja medible
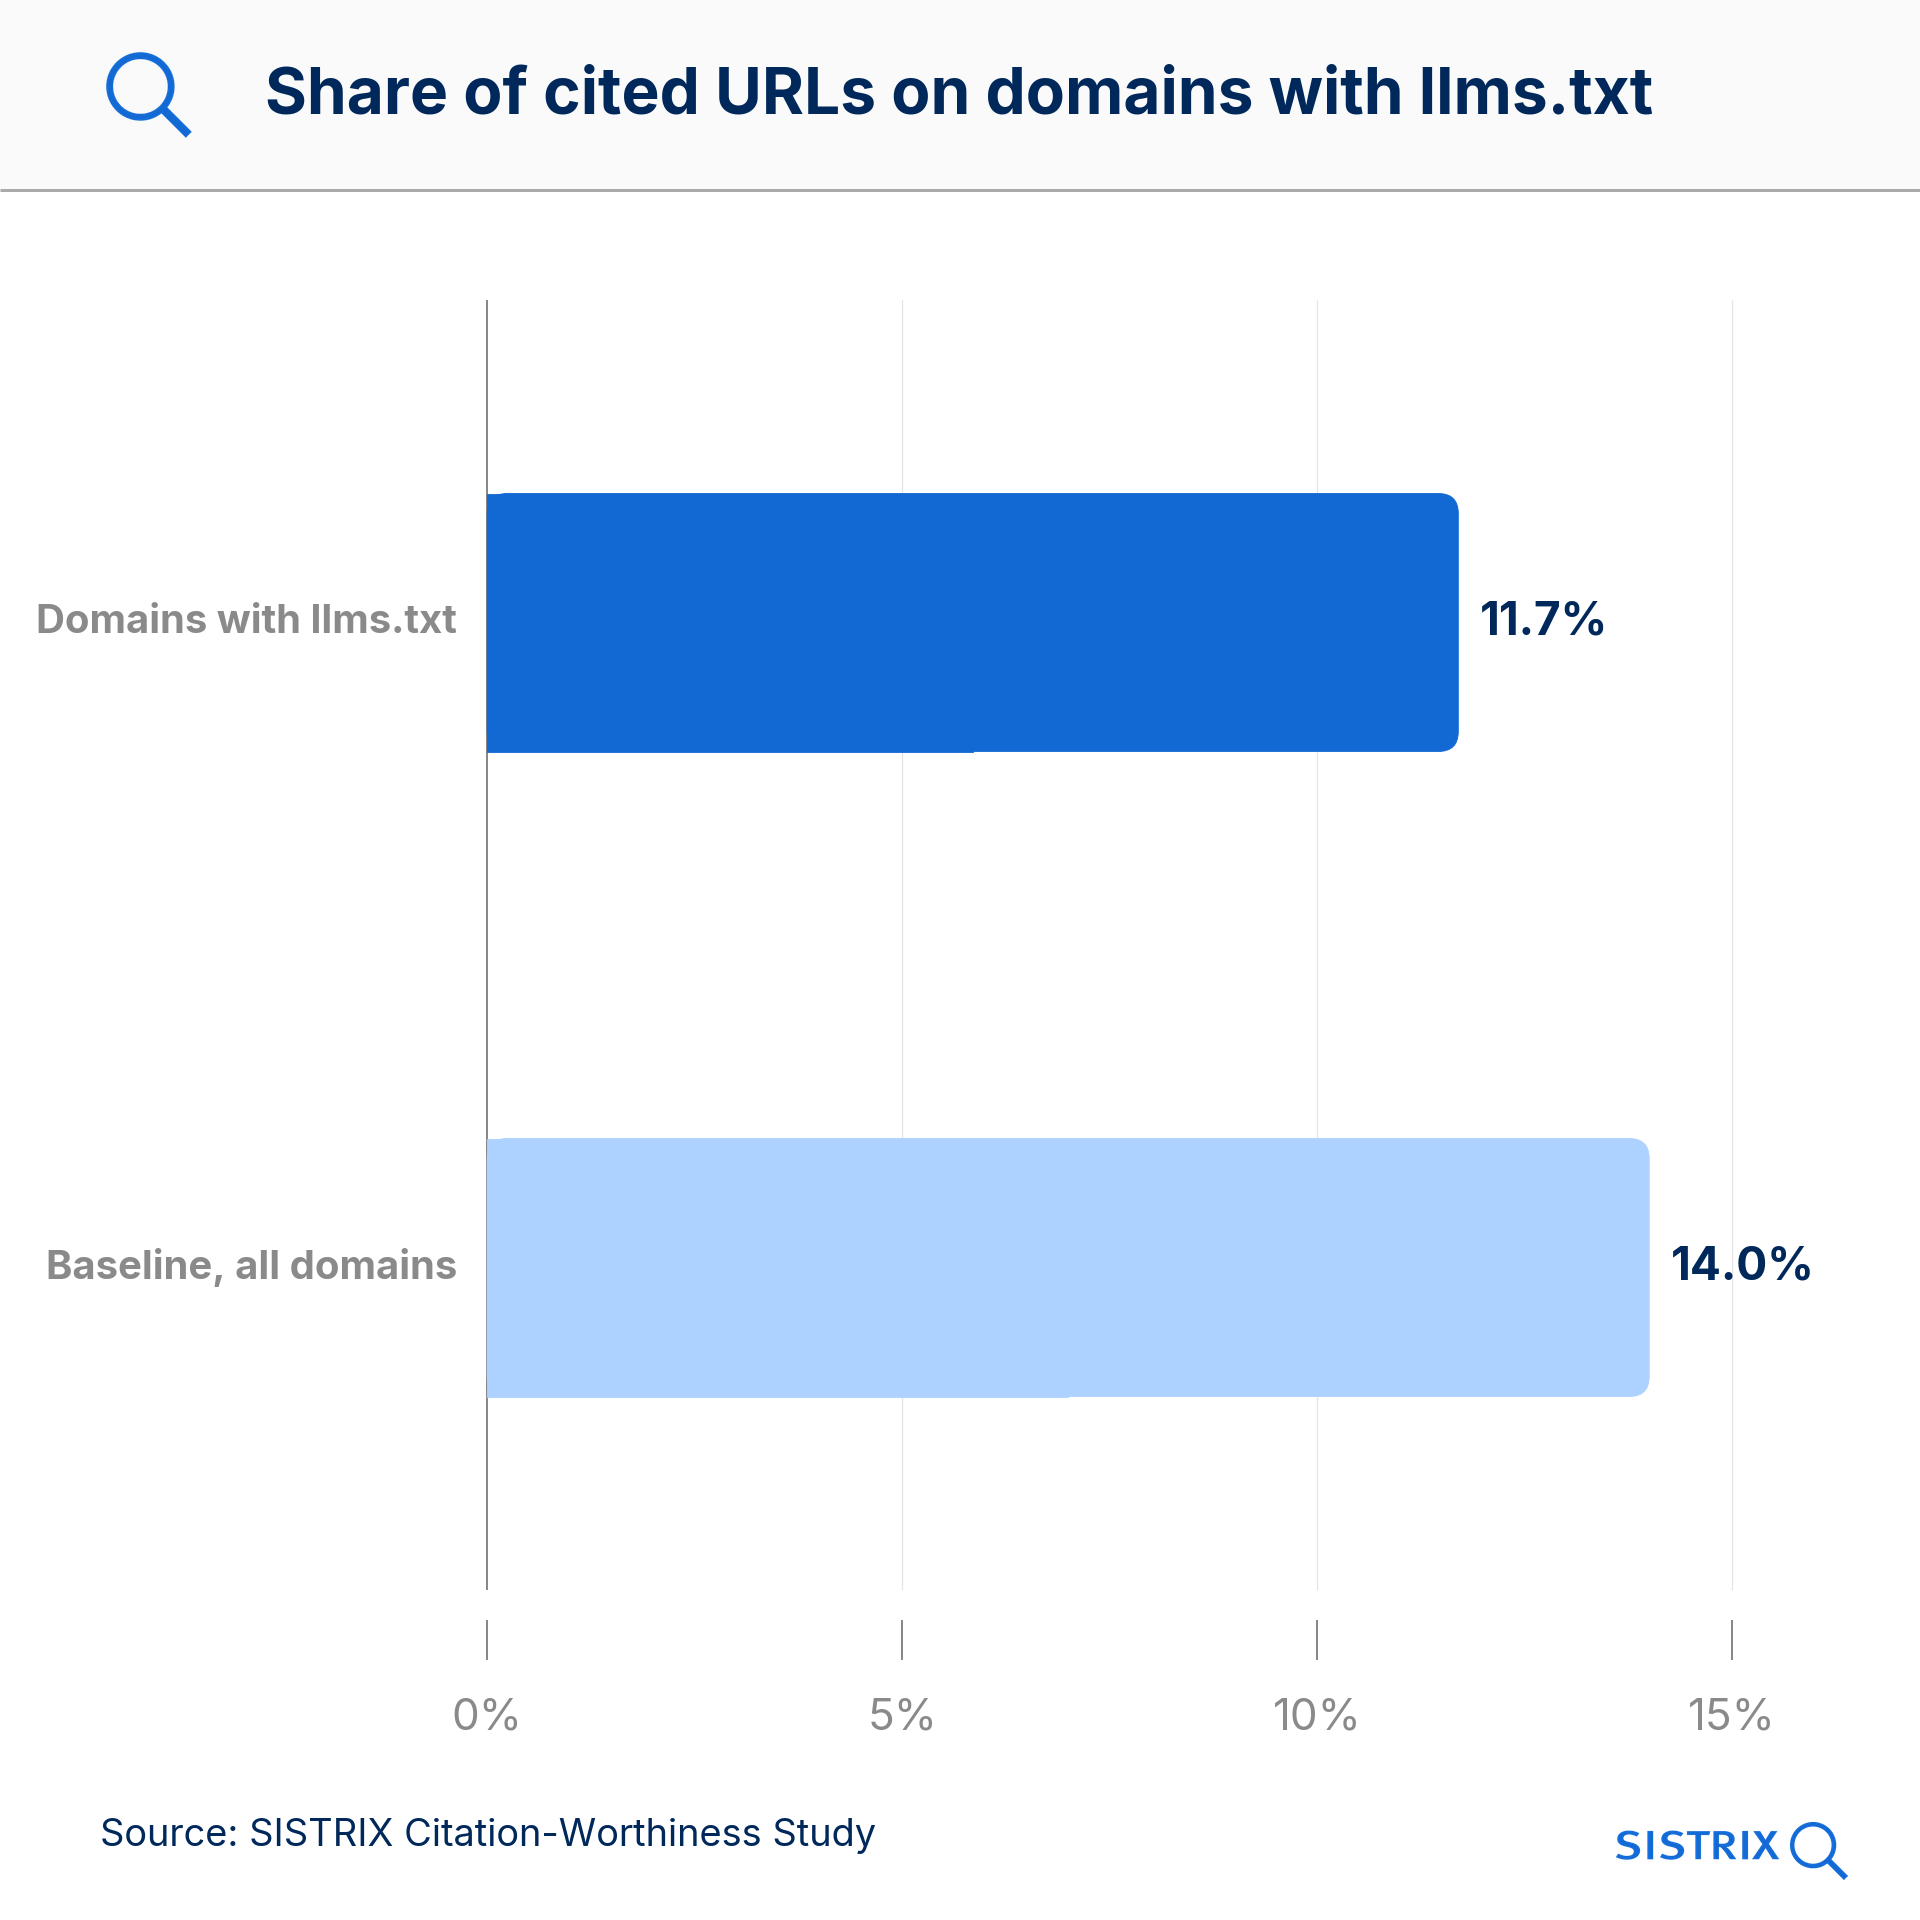
Pocos temas de GEO se han debatido tanto este año como el llms.txt. A día de hoy, no se aprecia ningún efecto medible en las citaciones de IA. Como el archivo afecta a todo el dominio, aquí hemos hecho una excepción y comparado dominios entre sí: del total de URLs citadas, el 11,7 % procede de dominios con llms.txt, mientras que su cuota sobre el conjunto de dominios es del 14,0 %. Es decir, los dominios con llms.txt están, si acaso, menos representados entre los citados. Aun así, esto no permite concluir que el archivo perjudique, porque los dominios comparados también se diferencian en muchos otros aspectos. Pero no debería ser una prioridad.
No todo el schema es igual
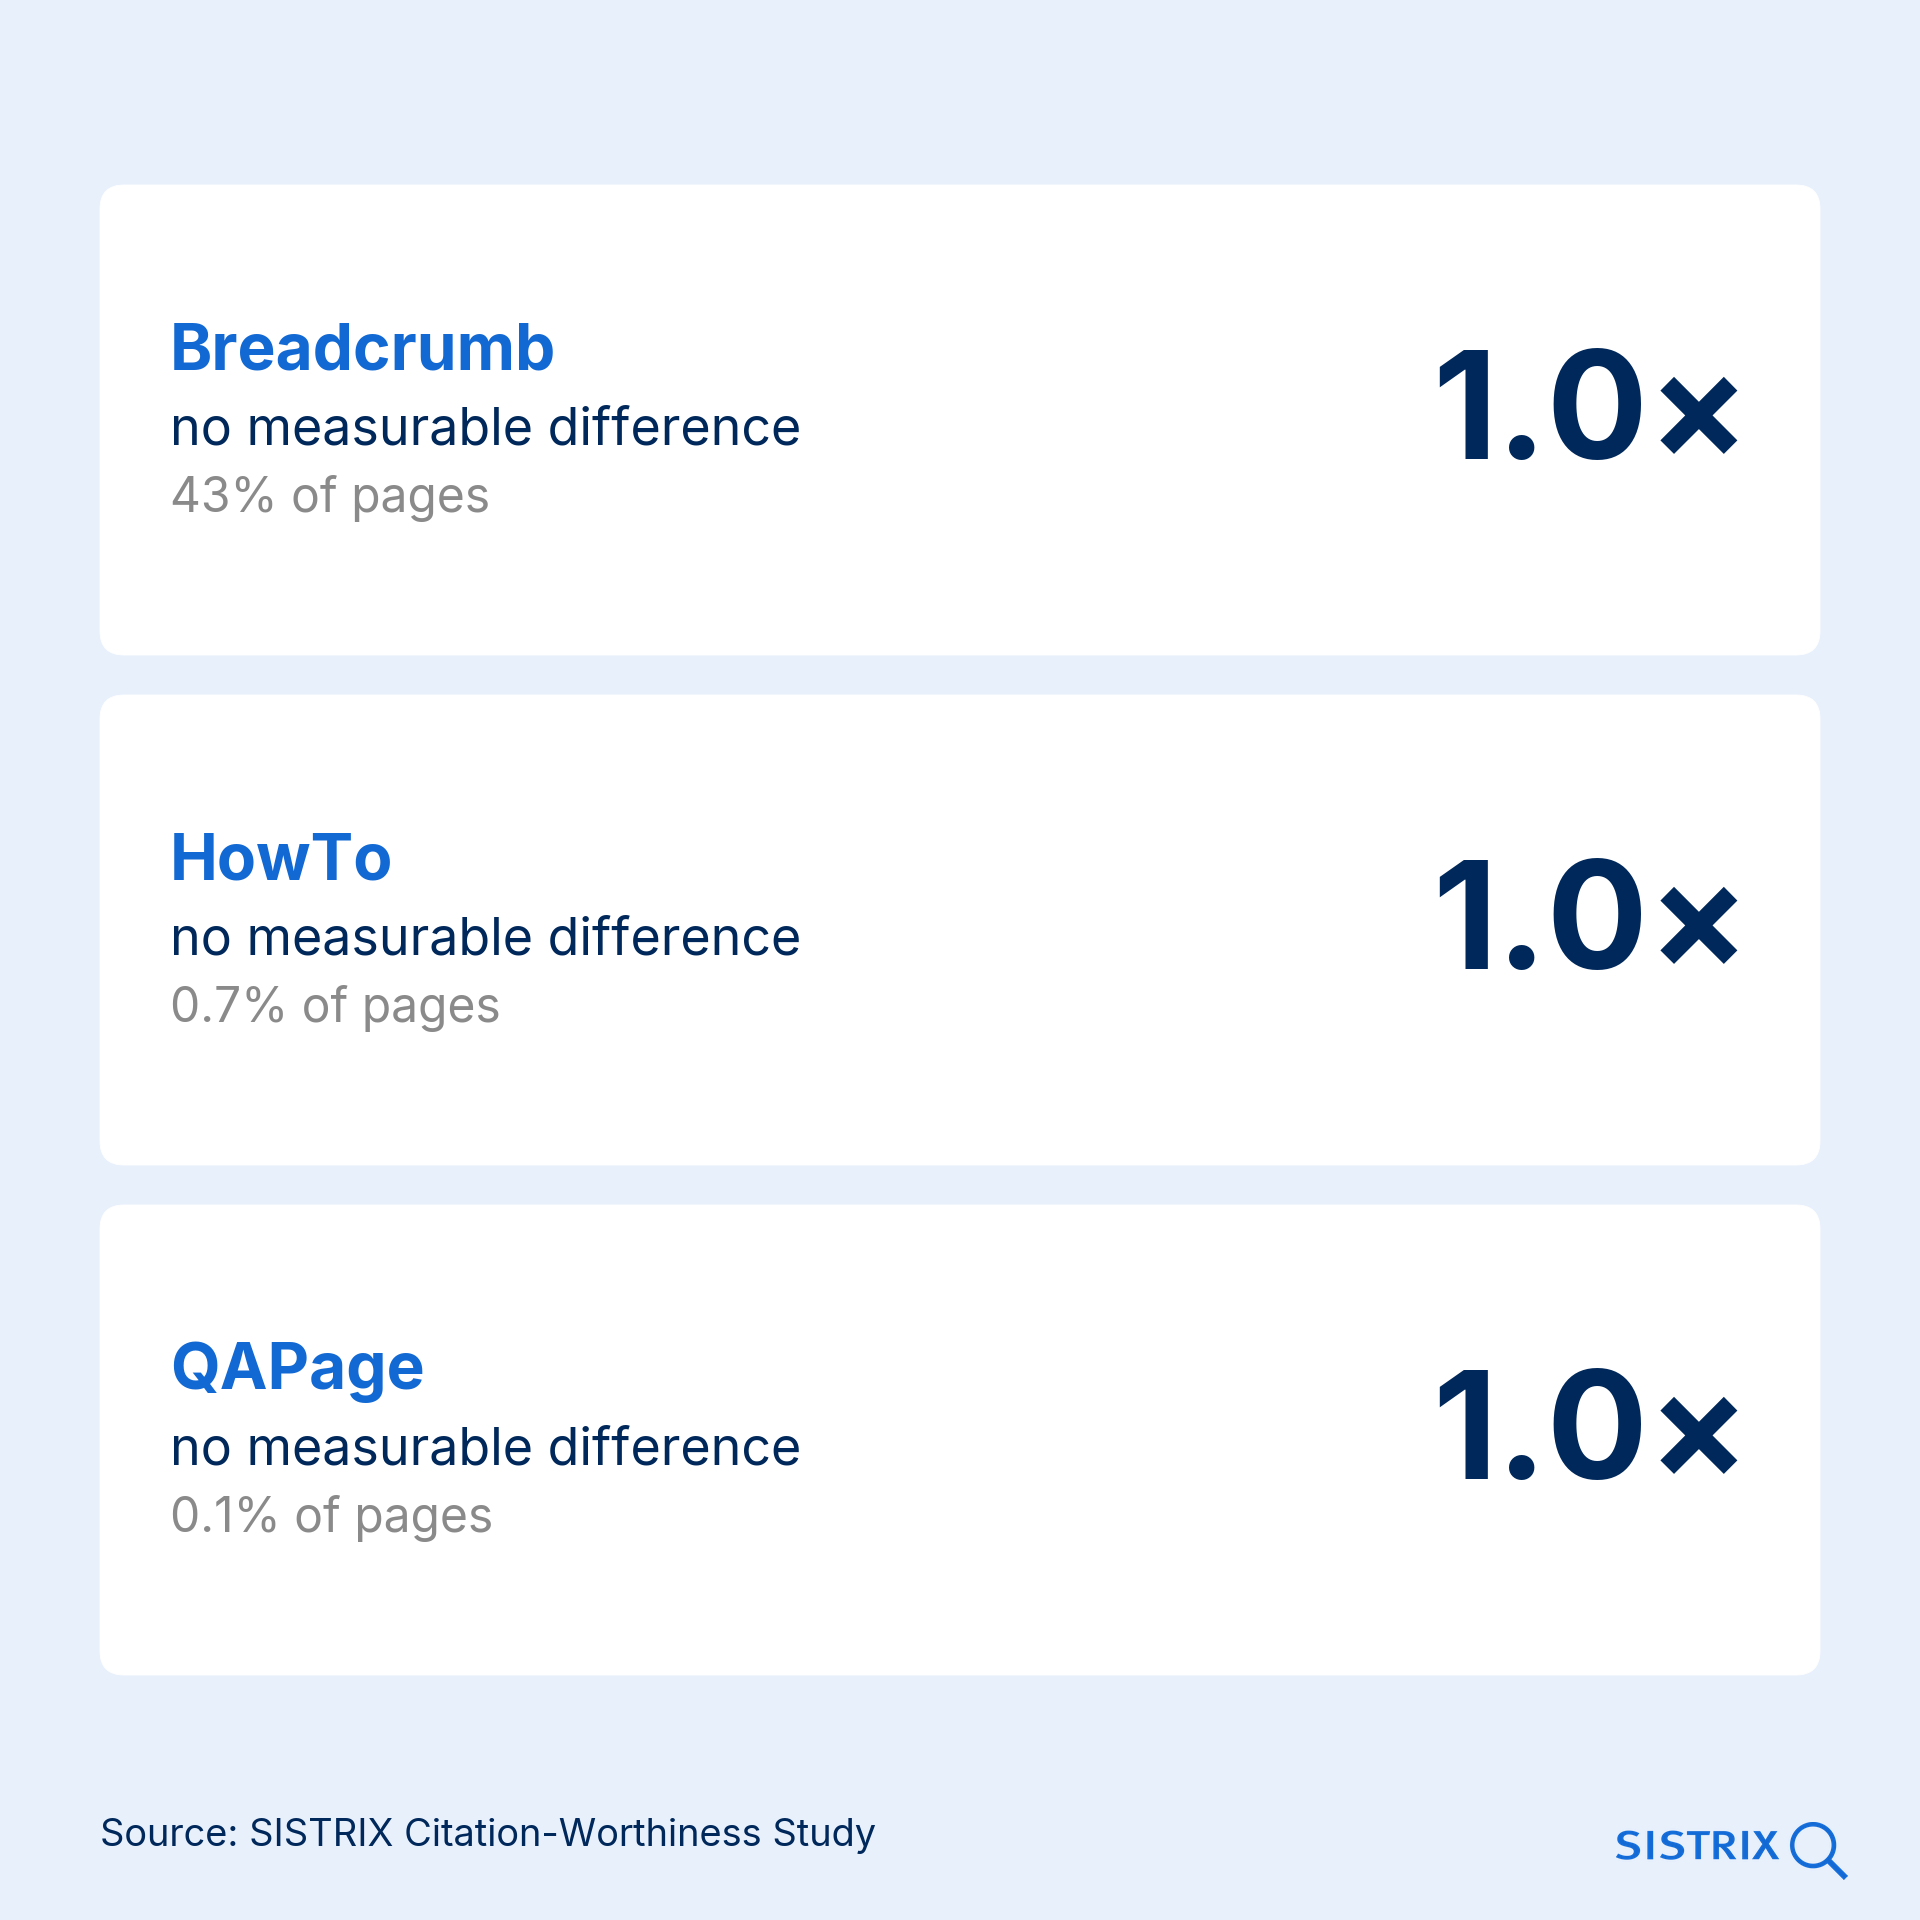
Los datos estructurados se consideran el arma milagrosa del GEO. Sin embargo, el marcado Breadcrumb, HowTo y QAPage no muestra ninguna diferencia medible (factor 1,0), a pesar de que las migas de pan aparecen en el 43 % de las páginas. Para la búsqueda clásica siguen teniendo sentido.
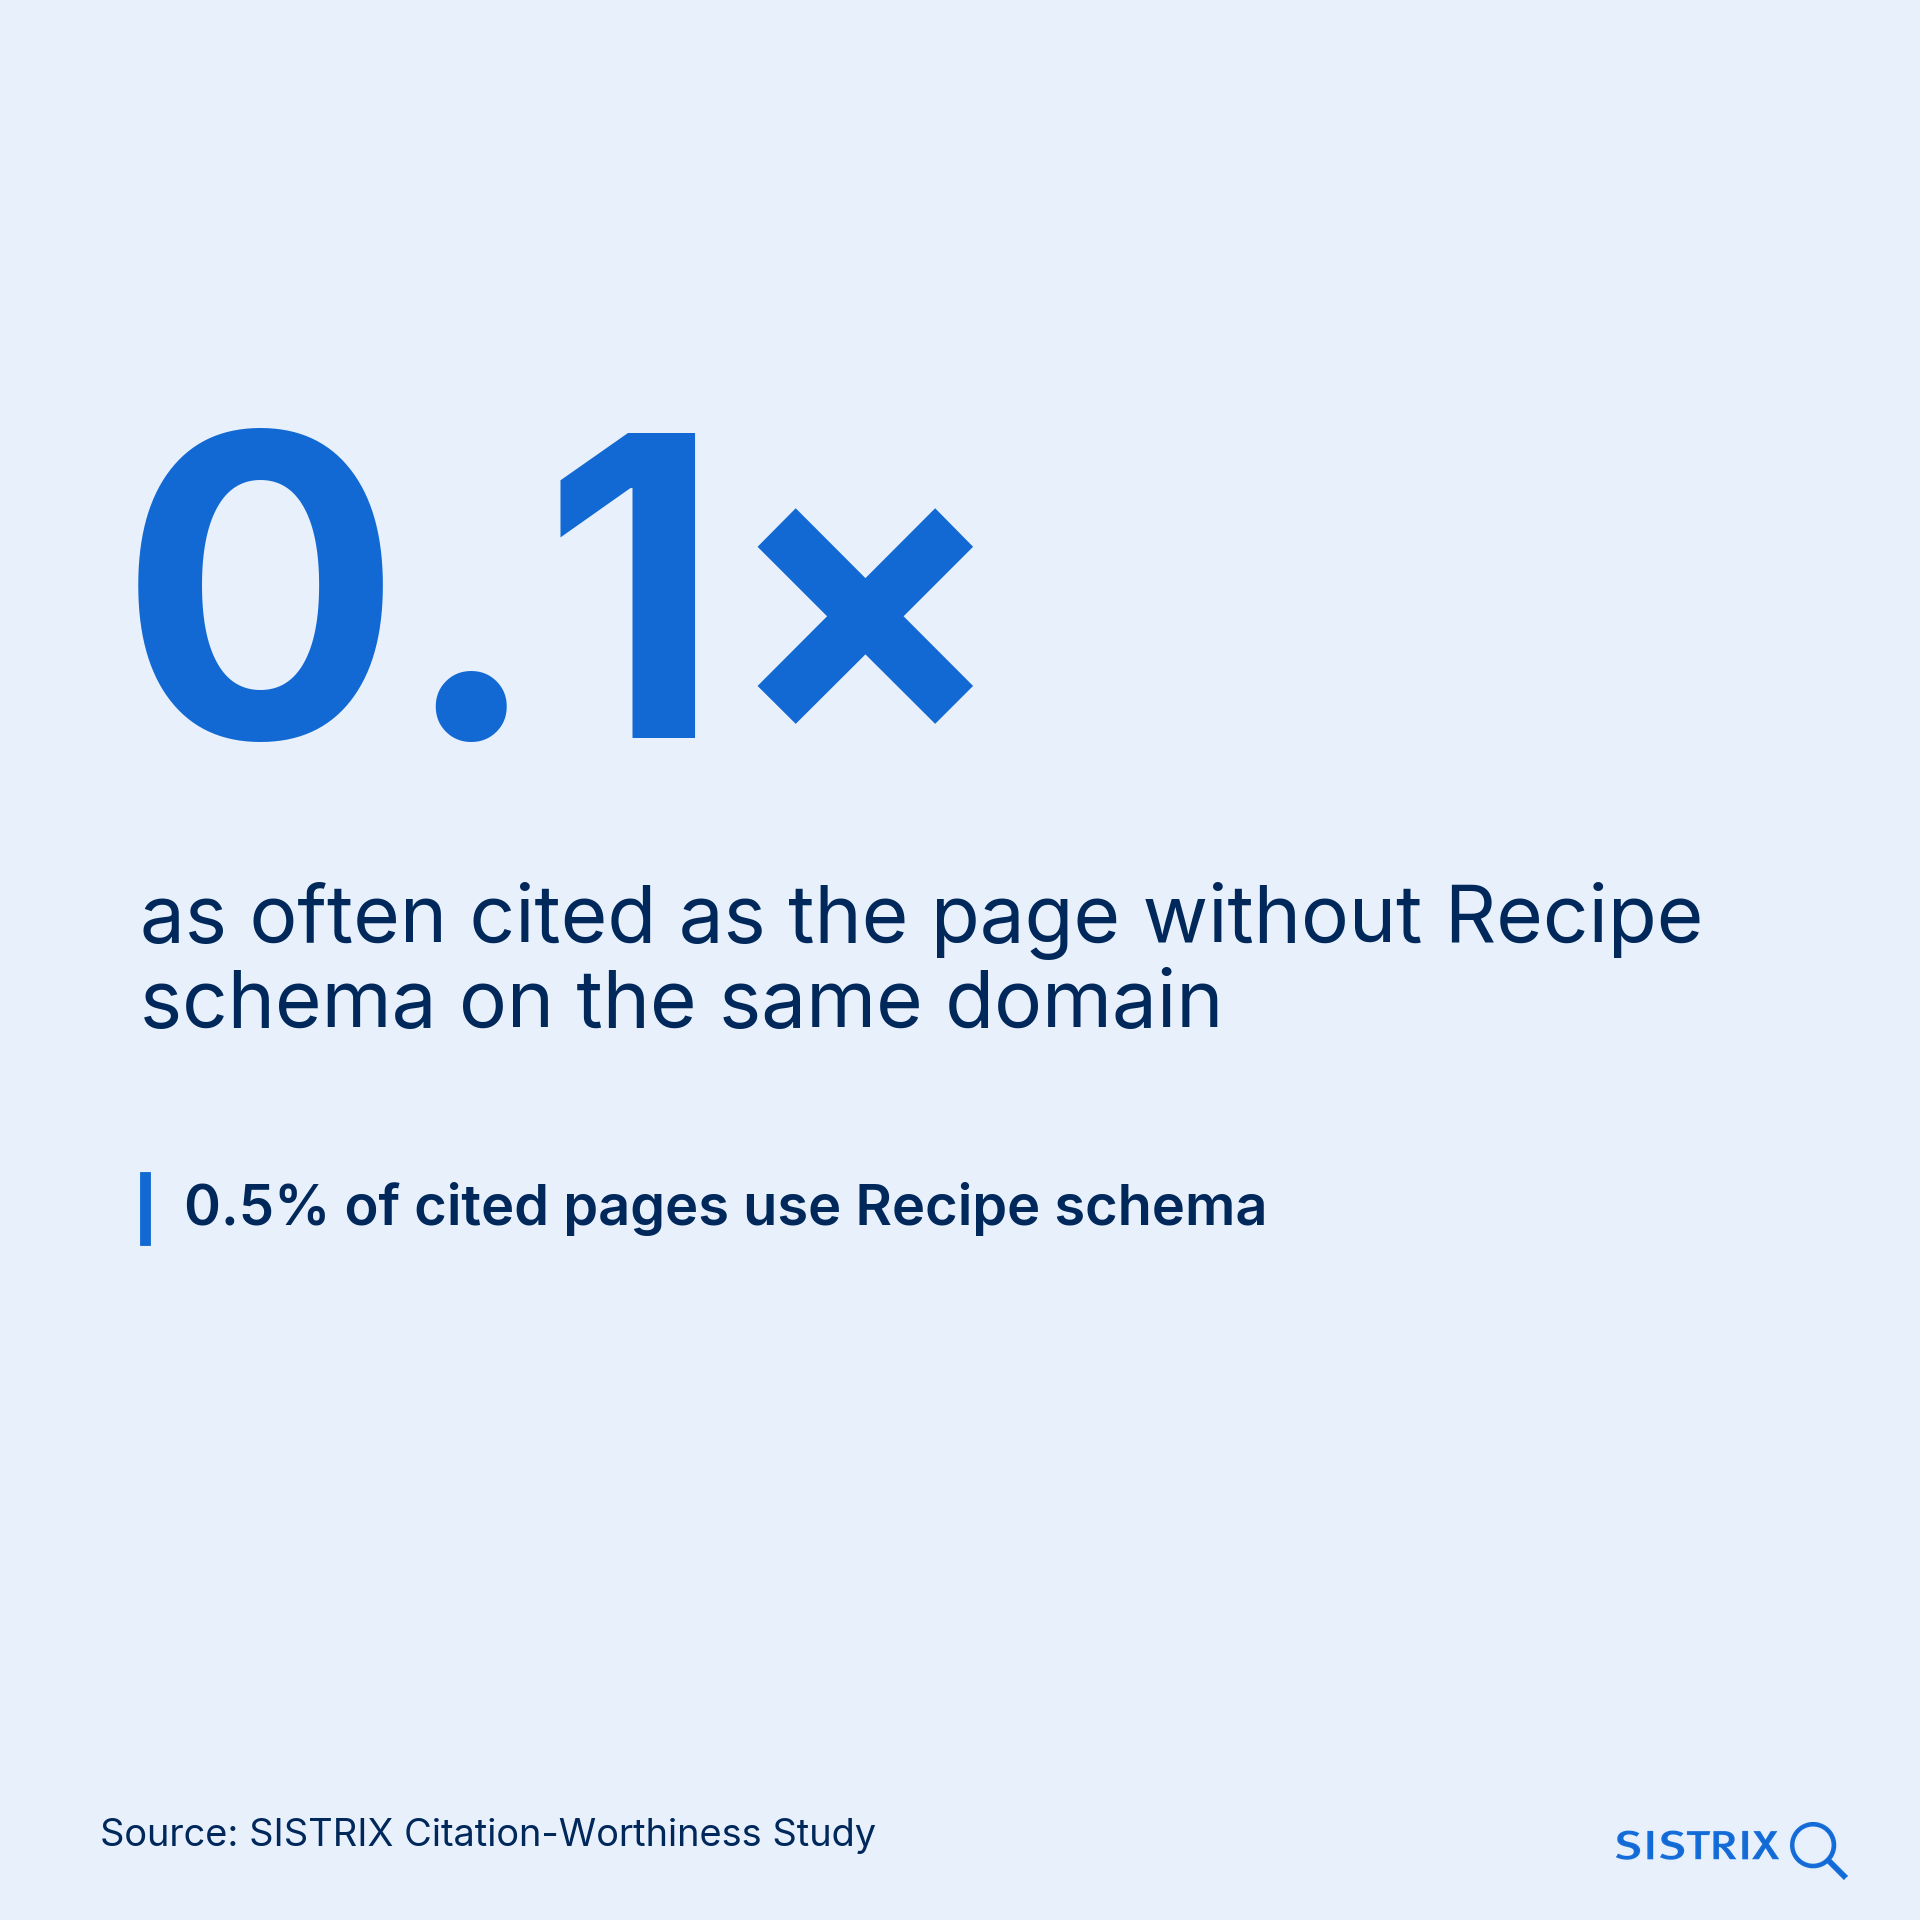
El schema Recipe incluso destaca en negativo: las páginas con este marcado se quedan en un factor de solo 0,1, y esto ocurre en todos los sectores para los que hay datos suficientes. Nuestra hipótesis, aún no validada: los modelos de IA prefieren remitir a una página temática antes que a una receta concreta. Para los medios gastronómicos, tiene sentido crear páginas temáticas y de resumen con schema Article como destino de las citaciones.
El schema Product (0,8; 0,5 en los AI Overviews) y hreflang se asocian a algo menos de citaciones. No es una palanca, pero tampoco motivo de preocupación: ambos marcados tienen su función fuera del GEO y deben mantenerse.
Legibilidad: importante para las personas, neutral para la IA
Los textos comprensibles siguen siendo importantes para los lectores. Sin embargo, una buena puntuación en el índice Flesch, que mide la comprensibilidad de un texto, no hace que una página sea más citable. El factor de 1,03 no es significativo.
Número de palabras: síntoma, no causa
Es cierto que las páginas con al menos 1.000 palabras se citan 1,5 veces más. Pero los textos más largos suelen tener también más encabezados, tablas y listas, así que el valor de la longitud refleja sobre todo una mejor estructura. Tratar los temas a fondo, sí. Escribir para alcanzar un número de palabras, no.
Plataformas y tipos de dominio: mismos principios, distinta ponderación
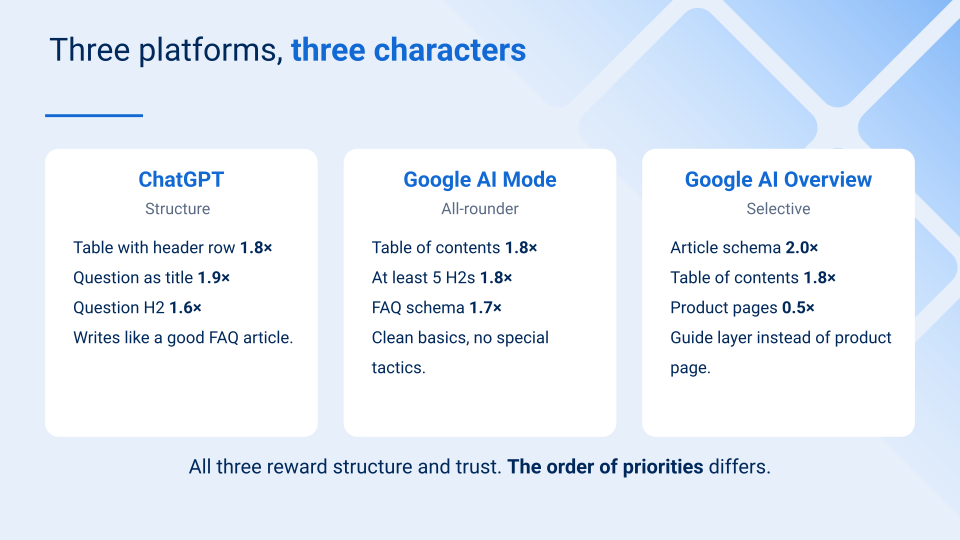
Las tres plataformas premian la estructura y la confianza, pero las ponderan de forma distinta. De antemano, esperábamos que los AI Overviews reaccionaran con más fuerza a las páginas bien optimizadas. En realidad, las tres plataformas están muy igualadas, con ChatGPT ligeramente por delante y los AI Overviews justo detrás. Una hipótesis menos.
- ChatGPT prefiere la estructura en torno a preguntas: las páginas con un título en forma de pregunta se citan allí 1,9 veces más, las que tienen tablas con fila de encabezado 1,8 veces y las que usan preguntas como encabezados H2, 1,6 veces. Dicho de forma sencilla, ChatGPT cita con gusto lo que está estructurado como un buen artículo de preguntas frecuentes.
- El AI Mode es el todoterreno. Ninguna característica destaca por sí sola, y lo que mejor funciona son unas bases bien hechas: las páginas con índice de contenidos o con al menos cinco encabezados H2 se citan, en cada caso, 1,8 veces más. Aquí no hacen falta tácticas especiales.
- Los AI Overviews son exigentes: las páginas con schema Article se citan aquí el doble (2,0), mientras que las páginas de producto solo la mitad (0,5). Se citan sobre todo contenidos informativos y menos páginas orientadas a la venta.
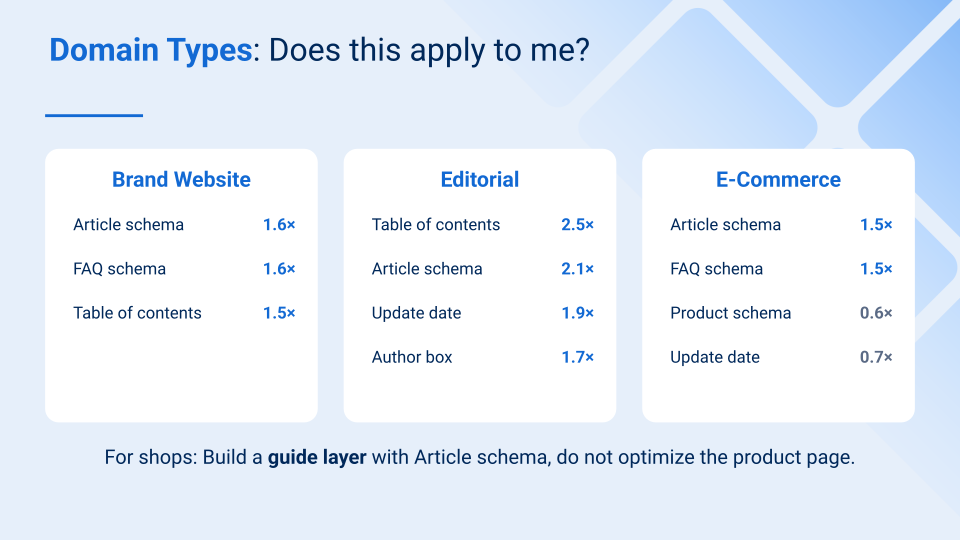
Qué características se asocian con más fuerza a las citaciones depende también del tipo de sitio web. En las webs de marca destacan sobre todo el schema Article y el schema FAQ (1,6 cada uno). En los medios editoriales, las páginas con índice de contenidos se citan 2,5 veces más y las que tienen fecha de actualización, 1,9 veces más. En las tiendas online ocurre lo contrario: allí una fecha de actualización visible se asocia a menos citaciones (0,7), igual que el schema Product (0,6). Por eso, para las tiendas, una sección de guías con schema Article es más prometedora que optimizar las páginas de producto. El schema Product muestra con especial claridad hasta qué punto importa el tipo de sitio web: en los proveedores de SaaS, las páginas que lo usan se citan 1,7 veces más, mientras que en los organismos públicos el factor es de apenas 0,1. Por último, en las enciclopedias, las optimizaciones en conjunto no muestran ningún efecto.
Conclusión: lo que puedes aplicar desde mañana
Los estudios pequeños llevan a engaño con facilidad, y las comparaciones entre dominios completos miden sobre todo la fuerza de marca. Dentro de un mismo dominio, en cambio, el panorama es claro: qué página se cita depende de forma medible de características onpage. Y lo que funciona sigue dos principios: estructura para la máquina, confianza para las personas. En la práctica, todo se puede resumir en una autoauditoría de once puntos:
- Imprescindible en cada página: índice de contenidos (1,7), schema Article (1,6), estructura H2 clara (1,6), caja de autor con foto (1,4).
- Cuando encaje con el contenido: bloque de preguntas frecuentes con schema (1,5), tabla con fila de encabezado (1,5), TL;DR al principio (1,3), fuentes enlazadas (1,3), fecha de actualización (1,3, sobre todo en contenidos editoriales). Nada de esto debe añadirse de forma artificial.
- Pequeño, pero medible: meta-descripción (1,2), varios tipos de datos estructurados (1,3).
En SISTRIX puedes comprobar qué páginas de tu dominio ya citan ChatGPT, el AI Mode y los AI Overviews.
Y si solo vas a hacer una cosa: estructura.
Cómo hemos medido
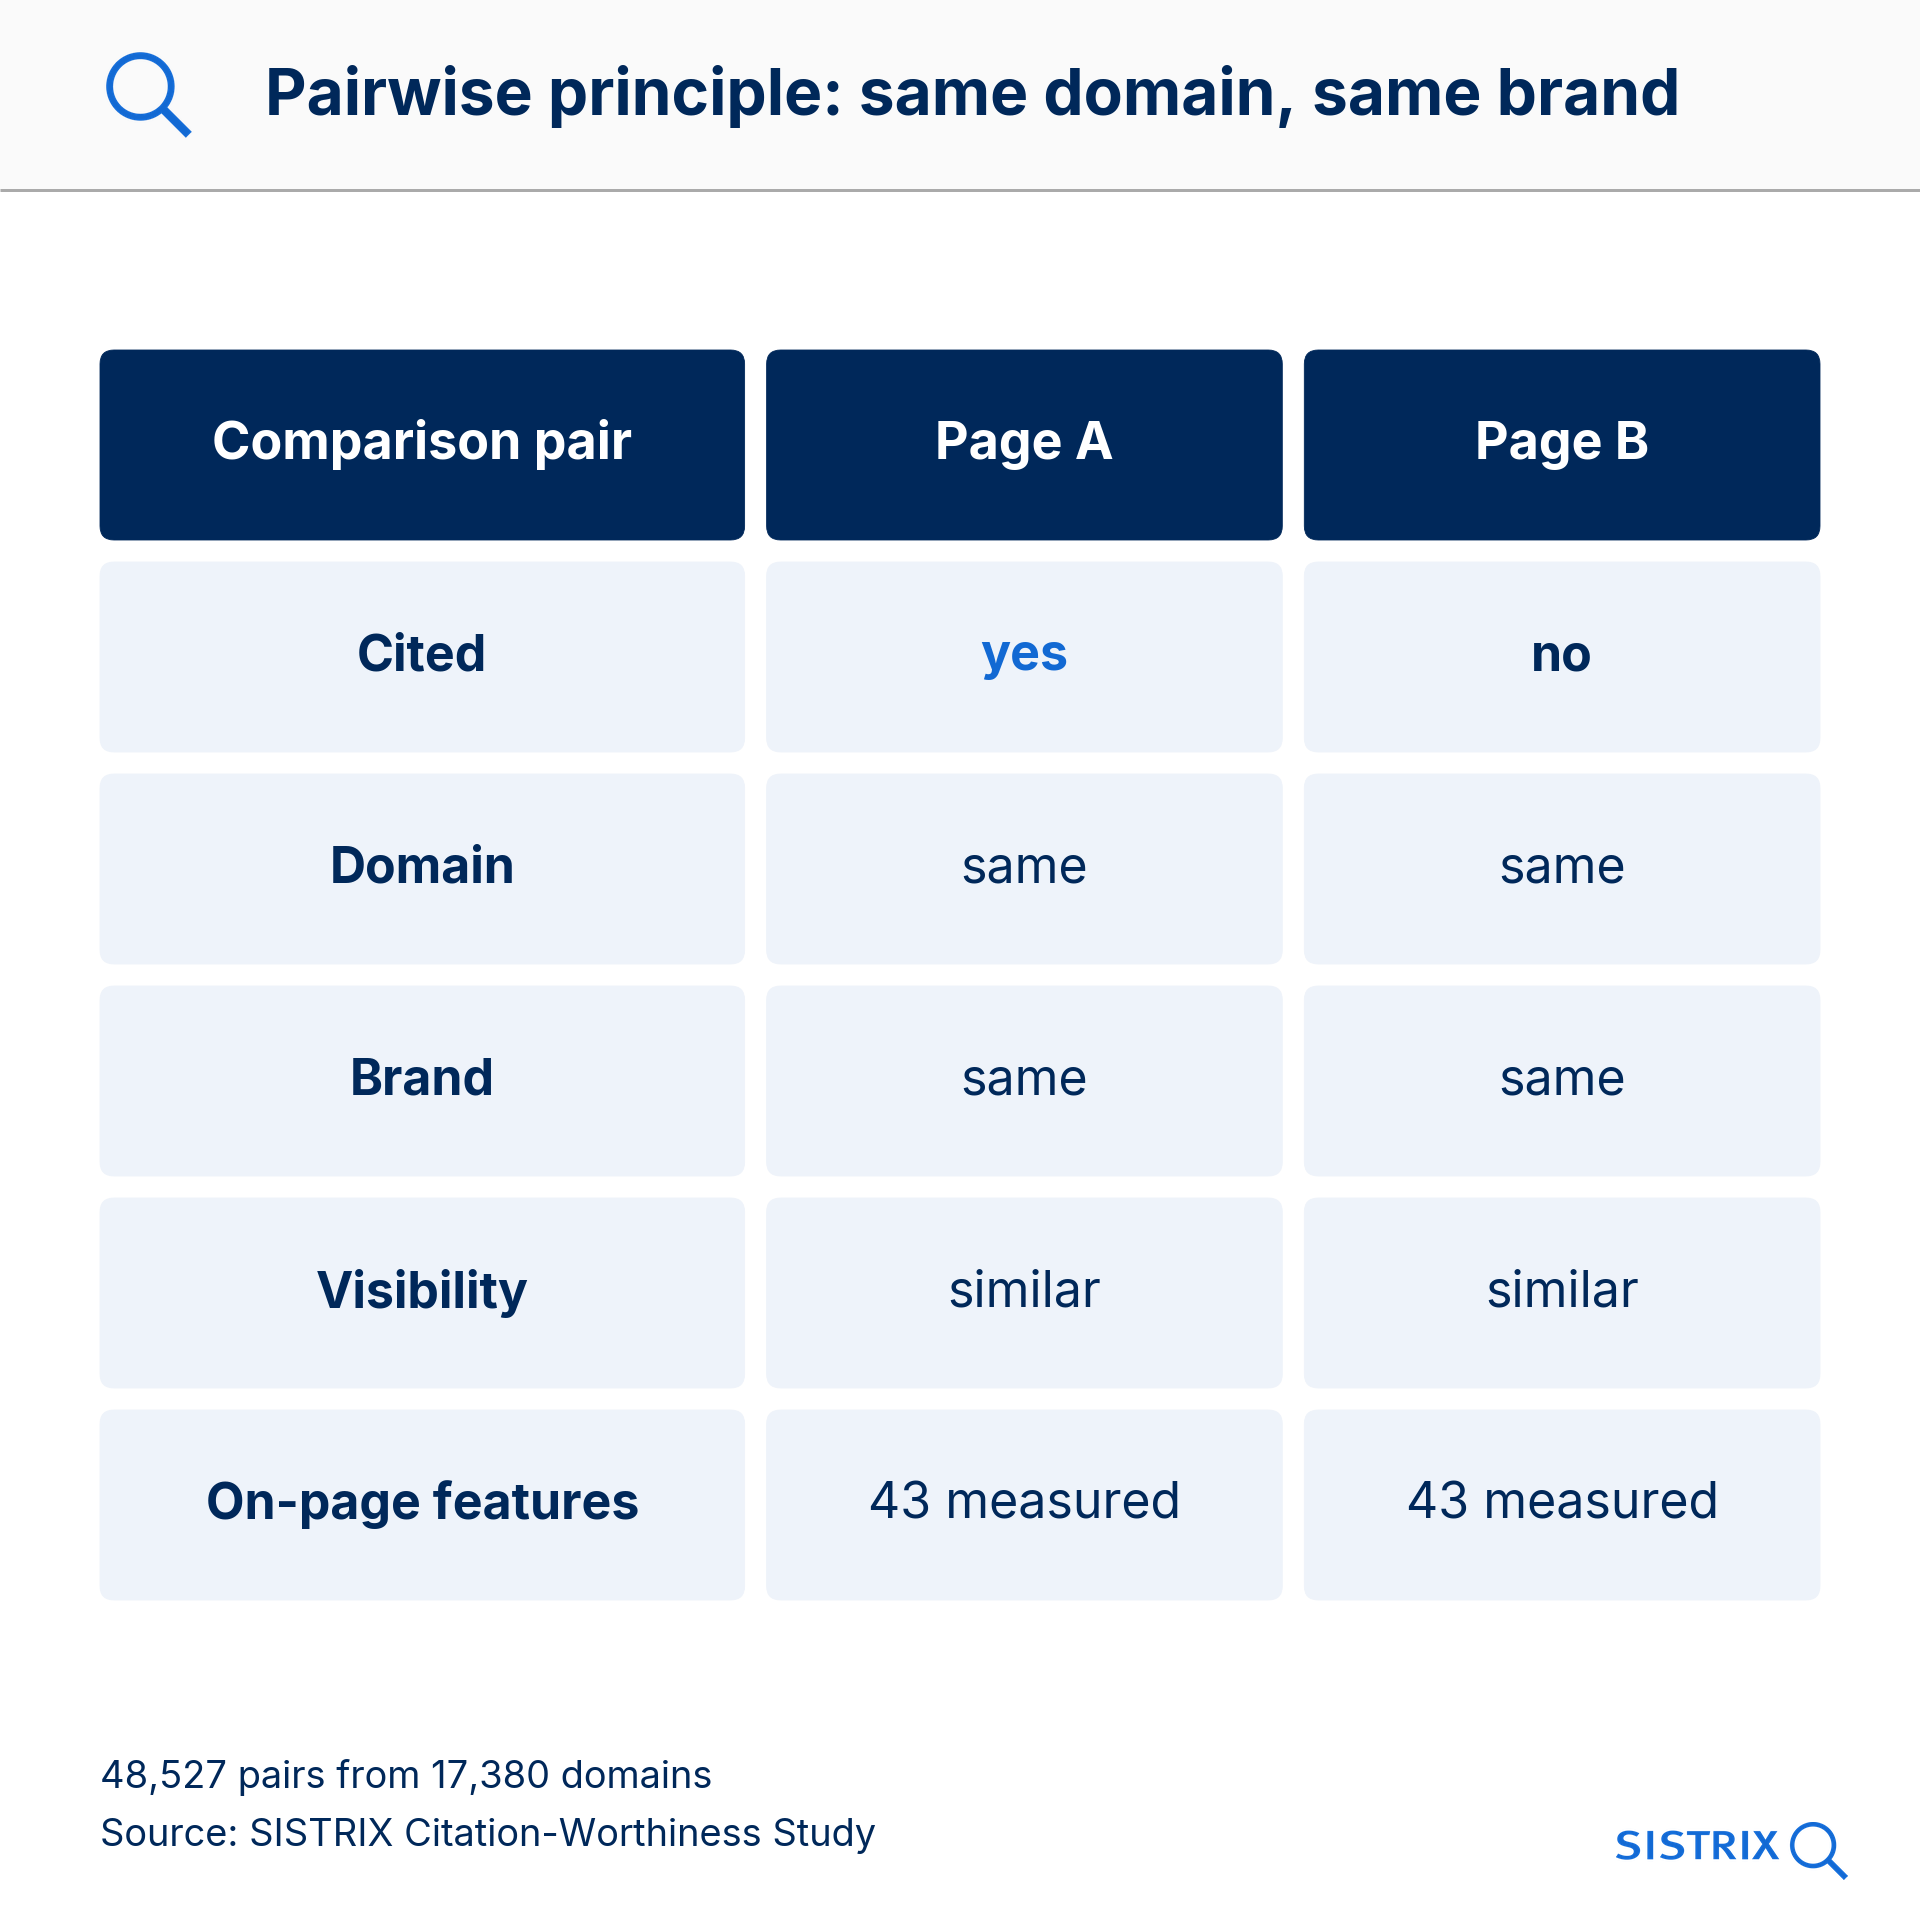
La base son 48.527 URLs citadas del AI Index de SISTRIX para la región DACH en el segundo trimestre de 2026, unas 16.000 de cada plataforma: ChatGPT, AI Mode y AI Overviews. Cada página citada se compara con una página no citada del mismo dominio. Así, la fuerza del dominio y de la marca no influye, y lo que queda es lo que depende de la propia página. En total, el análisis incluyó 96.418 URLs de 17.380 dominios con 43 características cada una. Por cierto, casi la mitad de las páginas citadas son guías y contenidos how-to (48,7 %), y la mayoría procede de webs de marca (38,7 %). La clasificación por tipos de dominio y de contenido la realizó Gemini 3.5 Flash. Una verificación cruzada con Gemini 3.1 Pro arrojó una coincidencia del 84 %, y además se revisó manualmente una muestra de 100 páginas.
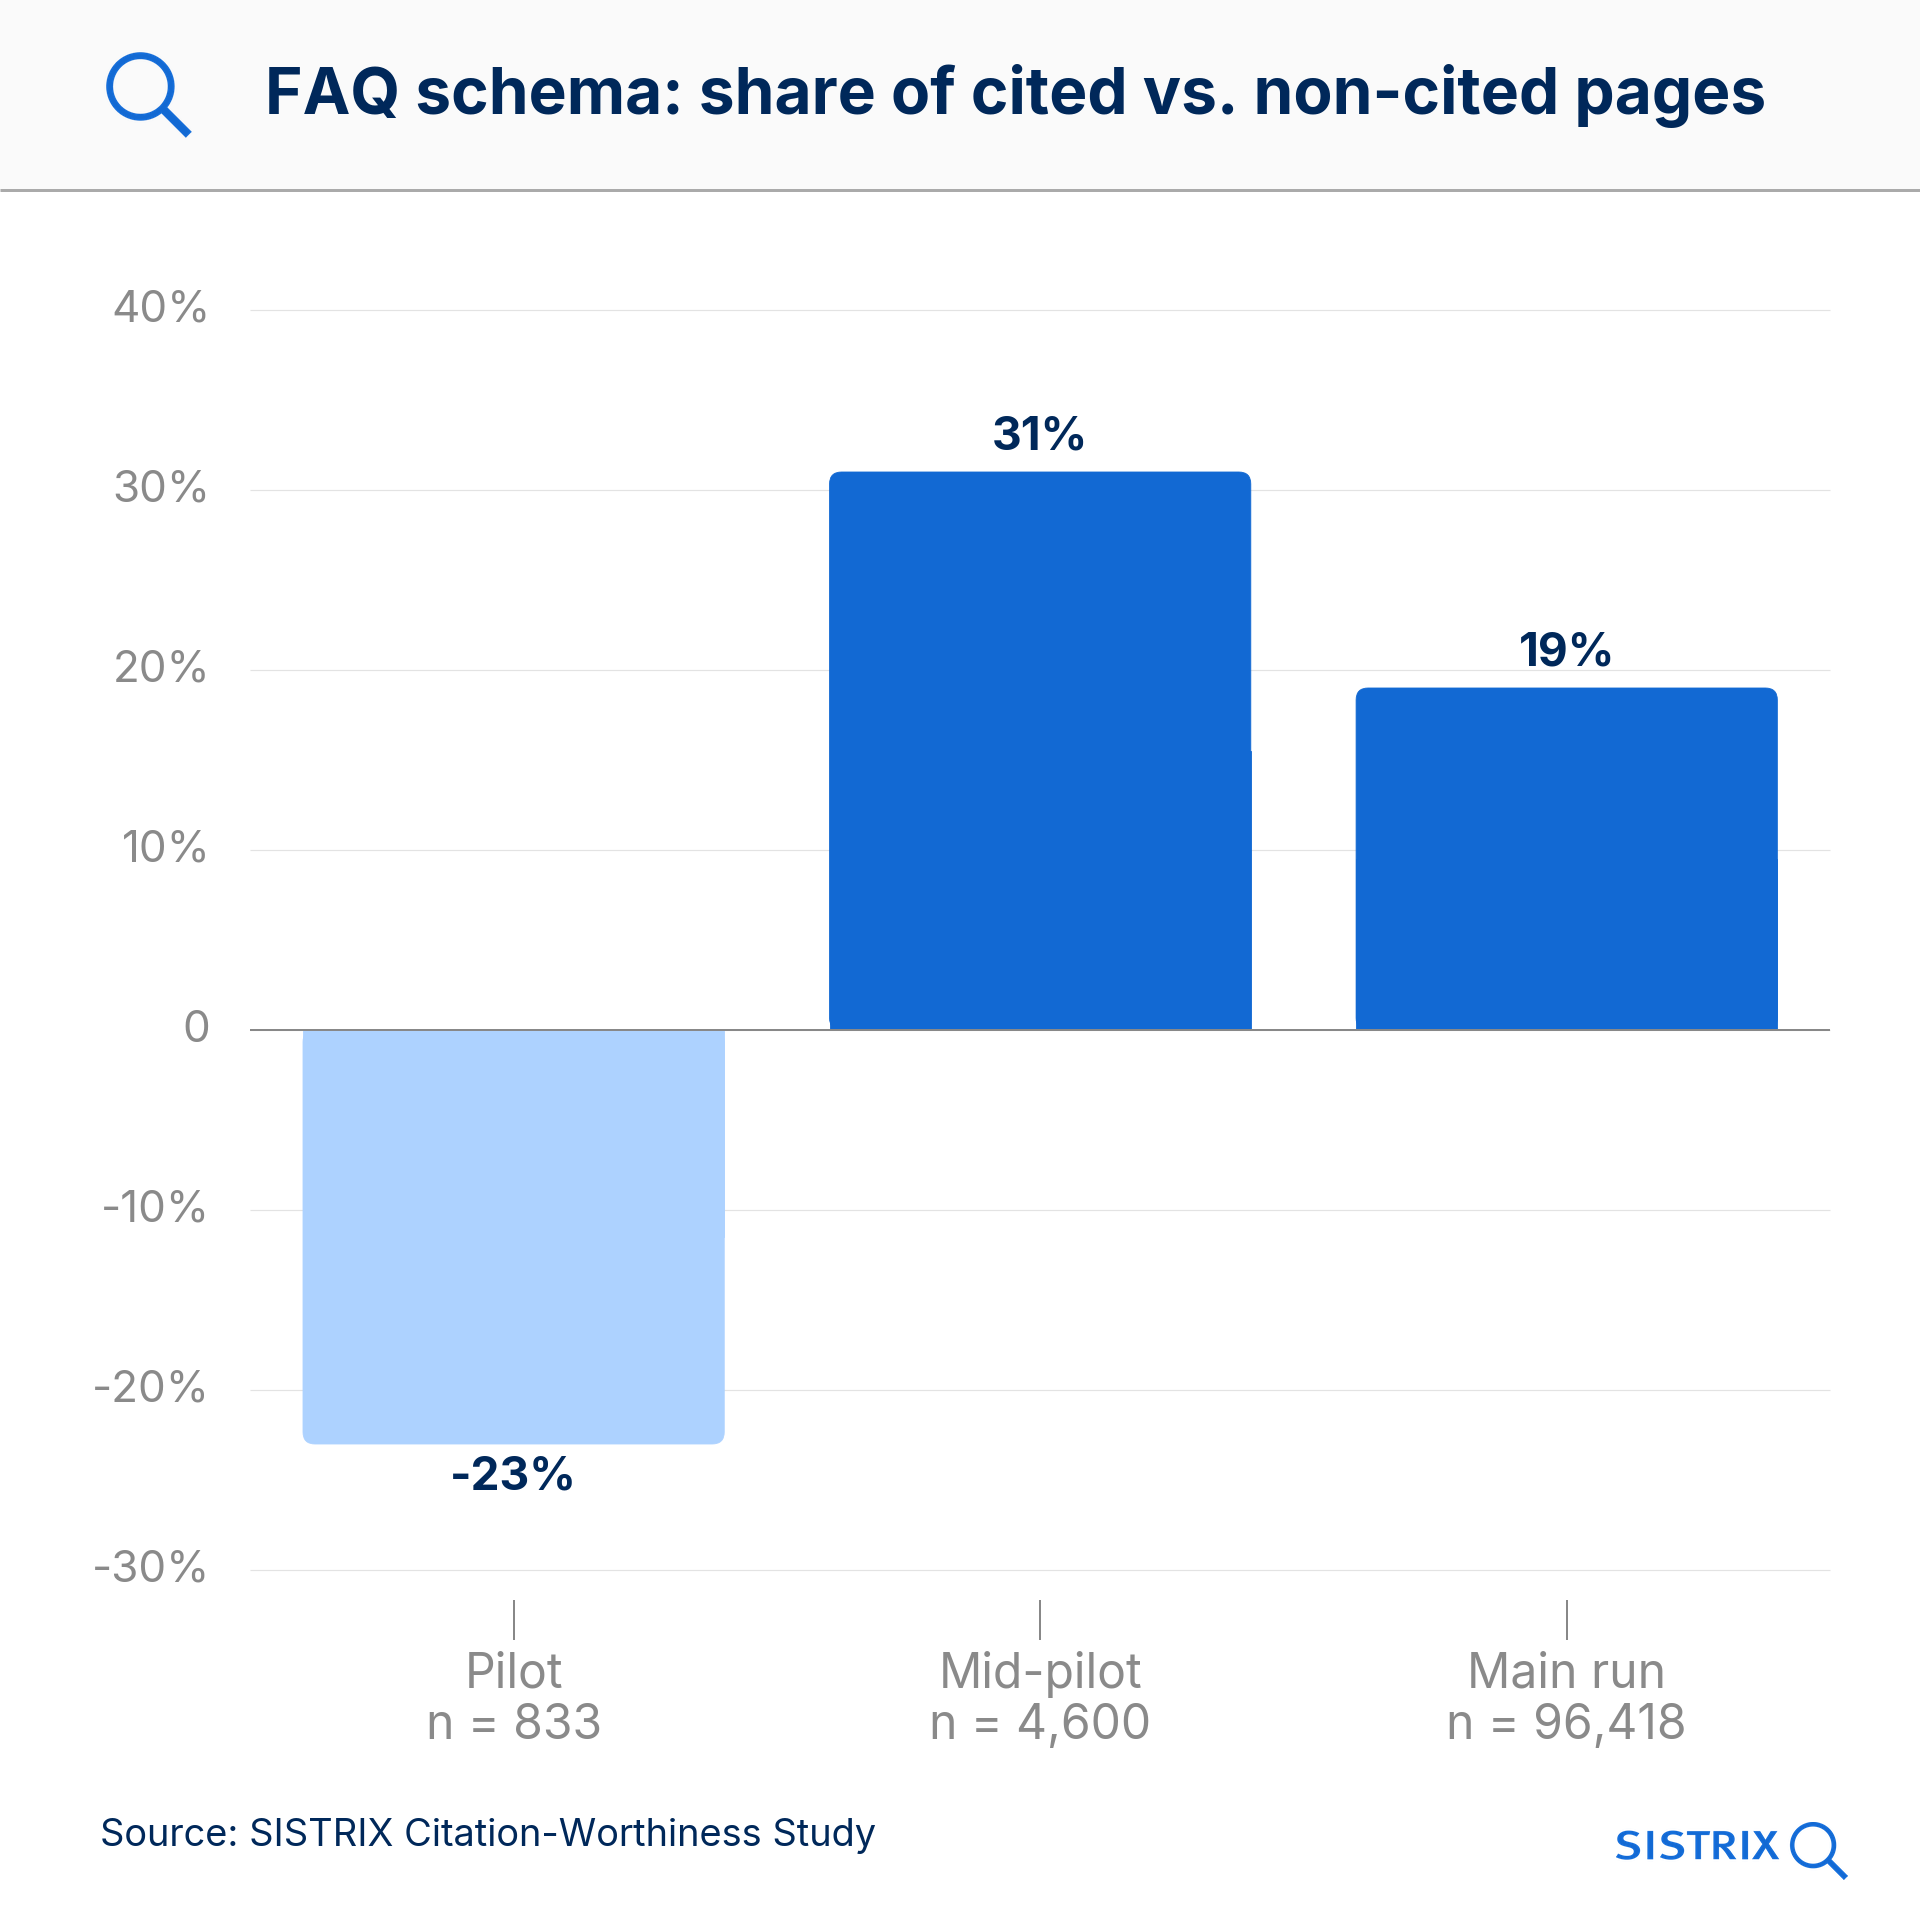
Nuestras pruebas demostraron lo importante que es el tamaño del conjunto de datos: con 833 URLs, el schema FAQ aparecía un 23 % menos en las páginas citadas; con 4.600 URLs, un 31 % más, y con 96.418 URLs, un 19 % más. Solo a partir de unas 5.000 URLs el resultado apuntaba de forma fiable en la misma dirección. De ahí sale una regla práctica sencilla sobre el tamaño de un estudio: no te fíes de un estudio de GEO con menos de 5.000 URLs. Esto también vale para este estudio: los valores de subgrupos concretos, como organismos públicos o enciclopedias, se basan en bastantes menos URLs y deben interpretarse con la debida cautela.
Como todo estudio, este también tiene sus límites: muestra correlaciones, no causas demostradas, y es una instantánea de la región DACH. Perplexity, Claude y el chat de Gemini no se analizaron. Está prevista una nueva edición.
FAQ: preguntas frecuentes sobre el estudio de Citation Worthiness
Citation Worthiness describe la probabilidad de que modelos de IA como ChatGPT, el AI Mode o los AI Overviews de Google citen una página como fuente.
Sobre todo, un índice de contenidos (1,7 veces más citaciones), schema Article (1,6), schema FAQPage (1,5) y una caja de autor con foto (1,4). Las páginas que combinan muchas de estas características se citan 2,1 veces más que las apenas optimizadas.
A día de hoy, no. No se aprecia ningún efecto medible en las citaciones de IA.
Depende del tipo de schema. Los schemas Article y FAQPage se asocian a bastantes más citaciones, mientras que el marcado Breadcrumb, HowTo y QAPage no muestra ningún efecto. El schema Recipe incluso se asocia a solo una décima parte de la probabilidad de citación.
De dos páginas del mismo dominio, la que tiene una característica determinada se cita X veces más que la que no la tiene. Técnicamente, se trata de odds ratios, que con una tasa de citación de alrededor del 1,4 % equivalen prácticamente a la relación de frecuencias.
Con una regresión logística condicional, que compara cada página citada con una página no citada del mismo dominio. Las pruebas múltiples sobre las 43 características se han corregido con el método de Benjamini-Hochberg. Las características de título y H1 se añadieron a posteriori y deben entenderse como primeros indicios.
Prueba SISTRIX gratis
- Cuenta de prueba gratuita durante 14 días
- Sin compromiso. No necesitas cancelarla.
- Onboarding personalizado con nuestros expertos.